新闻中心
新闻中心

新闻中心
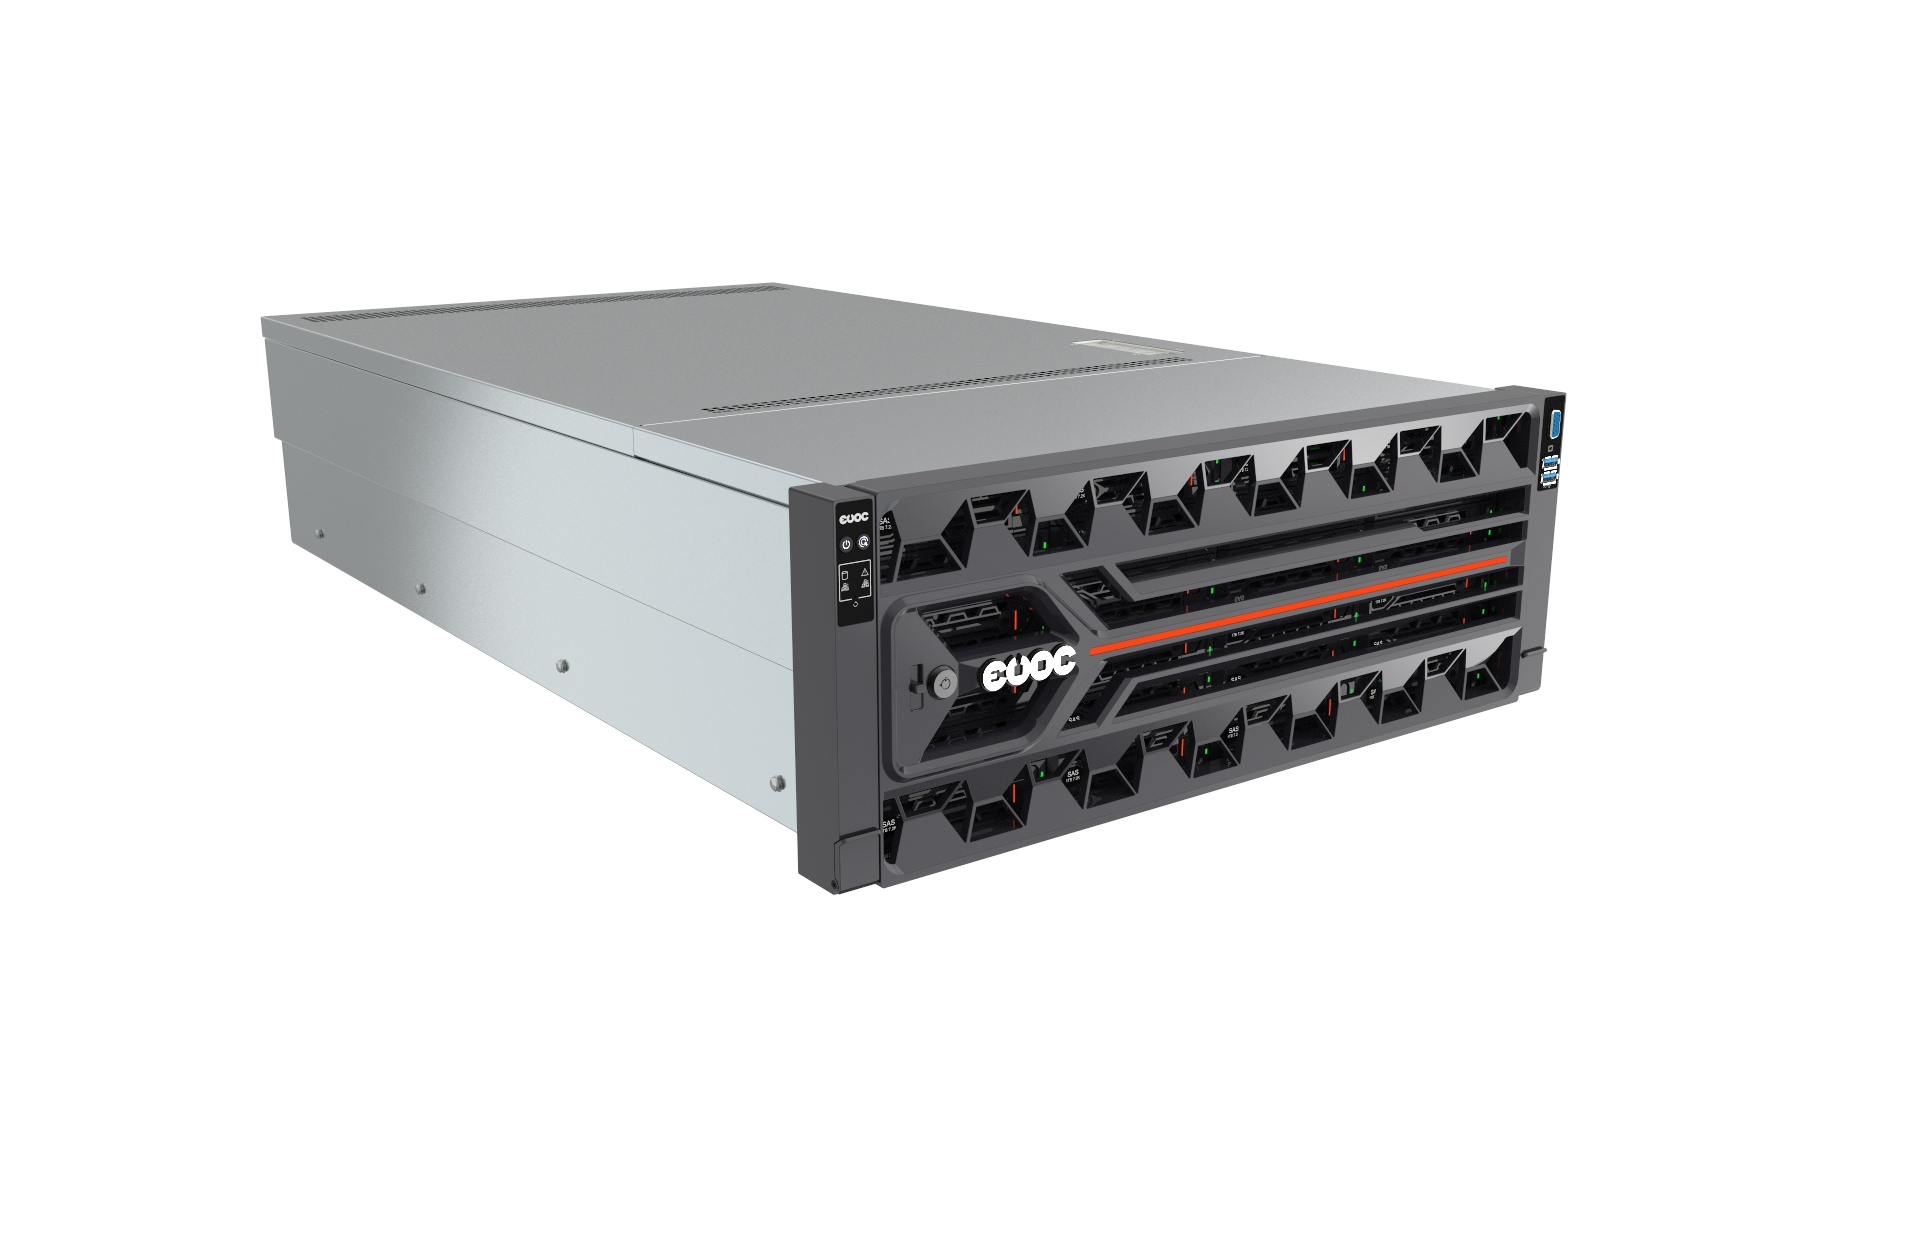
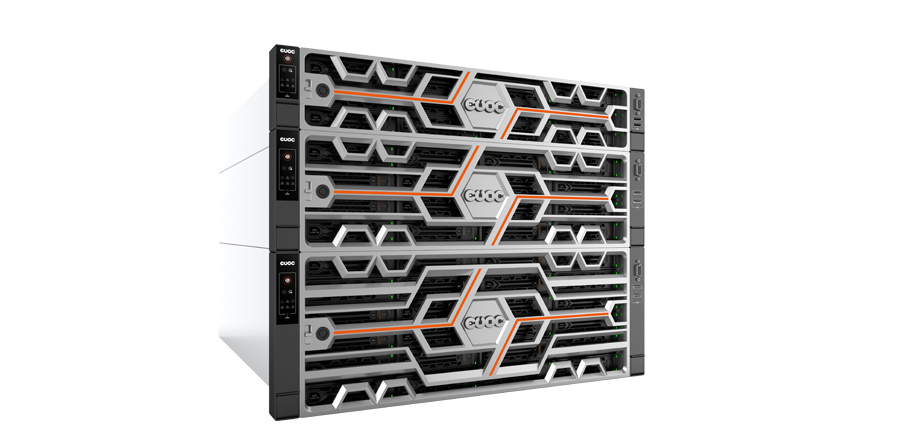
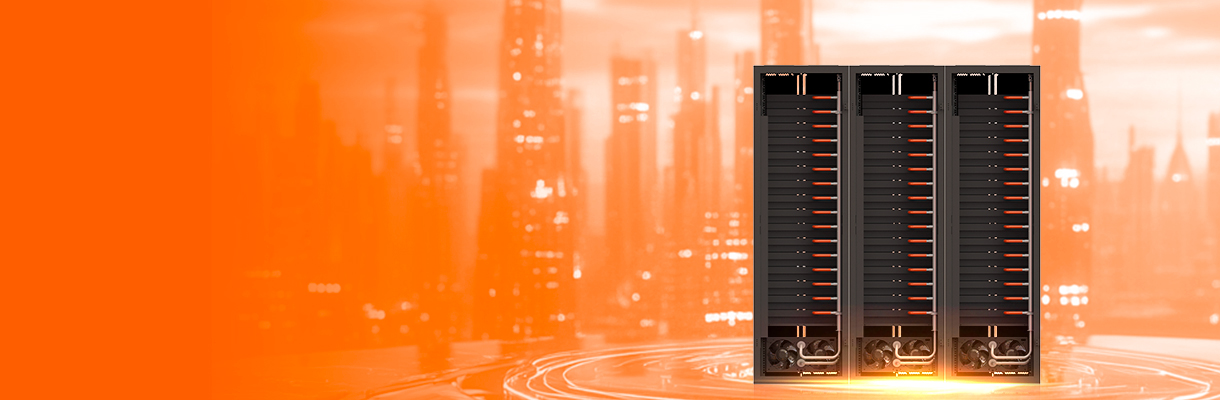
摘要:训推一体服务器怎么选,关键不是堆GPU数量,而是同时核对GPU密度与互联拓扑、内存与本地存储、散热与供电三条主线。亿万克G852N7是面向AI训练、推理与高性能计算的4U双路异构服务器,对于预算有限、又需要在模型微调与在线推理之间反复切换的团队,通常比分别采购训练机与推理机更省机柜位、供电与运维成本。本文帮你拆解国产AI算力服务器的选型逻辑。
训推一体服务器是指同一台算力底座,能够按业务需求承载模型训练、模型推理,或让两类任务并行运行的GPU服务器;它兼顾多卡互联与本地存储,而纯训练机侧重互联带宽、纯推理机侧重单卡显存与能效。
对比维度 | 训推一体服务器 | 纯训练服务器 | 纯推理服务器 |
核心目标 | 微调+推理分时复用,提升综合利用率 | 大规模预训练、全参数微调 | 高并发在线推理 |
硬件侧重 | 多卡扩展+本地存储+互联拓扑平衡 | GPU-GPU互联带宽、显存总量 | 单卡显存、能效、并发吞吐 |
资源利用率 | 训练/推理错峰复用,闲置率低 | 推理阶段易闲置 | 无法承担训练,功能单一 |
TCO构成 | 一台整机+一套机柜/供电/运维 | 训练机+推理机两套投入 | 仅推理投入,但扩容需再加机 |
典型配置 | 4U双路、8卡级GPU、大容量NVMe | 8–10卡、NVLink高速互联模组 | 4–8卡推理卡 |
适用规模 | 中小规模集群、训推混跑团队 | 大模型预训练团队 | 推理为主的线上业务 |
训推一体服务器的TCO要算三本账:采购账、机房供电账、运维账。一台8卡4U整机可覆盖微调到并发推理,相比训练机与推理机分开采购,少一套机箱、少一个机柜位、少一路供电冗余,也少一套监控运维入口。
先看机房与供电这笔账。亿万克G852N7作为4U高密算力整机,配备2000W/2700W/3200W热插拔冗余电源,支持2+2/3+1冗余,可按业务负载灵活配置,便于纳入标准机柜统一规划。相比训练机与推理机分置带来的两套机柜位、两路供电与两套运维入口,训推一体把两类负载压进同一台机器,固定投入更集约,部署也更简洁。
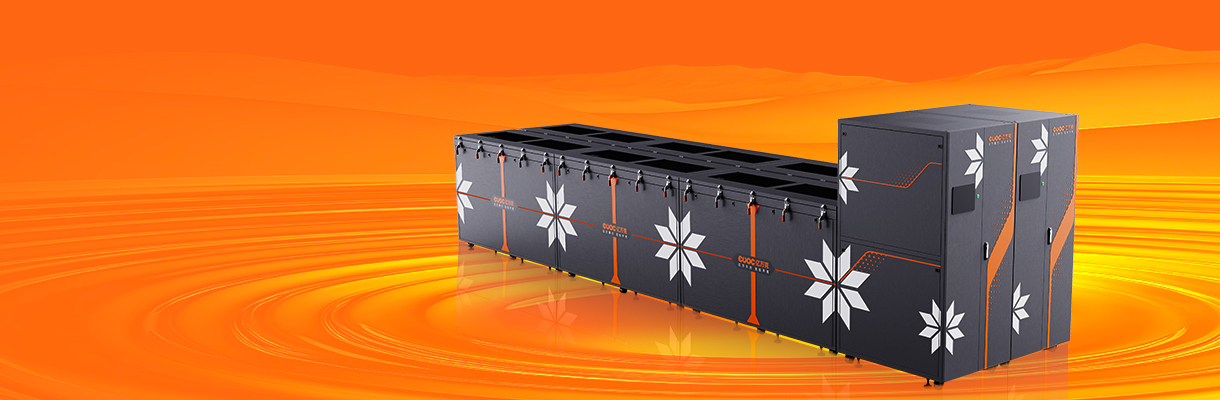
再看能耗与散热账。据工信部数据,2024年我国算力设施用电量达1660亿千瓦时,约占全社会用电量的1.7%,"十四五"以来年均增速超过10%。国家发改委等四部委《数据中心绿色低碳发展专项行动计划》要求,2025年底新建及改扩建大型、超大型数据中心PUE降至1.25以内,国家枢纽节点项目不得高于1.2。亿万克全浸没式液冷系统PUE可低至1.05以下,相比传统风冷节能超54%、相比冷板式液冷额外节能约12%。
因此,训推一体+"高密度整机+适配的散热路线"这一组合,节省的是持续性的电费与机柜空间,而不是一次性的采购折扣。 对7×24运行的负载,散热与供电的长期成本往往比硬件差价更值得关注。
选国产AI算力服务器,先按5条标准逐一核对:GPU密度与互联拓扑、内存与本地存储、散热与供电、运维管理能力、算力代际与折旧节奏;把需求填进这张表,再去比价。
1、GPU密度与互联拓扑:先确定训练是否需要多卡高速互联、推理需要几张卡。亿万克G852N7支持CPU-GPU直通及Switch方案,并支持多种CPU-GPU与GPU-GPU互联拓扑,直通模式最大8张双宽GPU、Switch模式最大10张。判定要点:先按显存总量算模型能否装下,再决定是否为互联额外付费。
2、内存与本地存储:训练数据、模型文件、Checkpoint都依赖本地读写。G852N7配备32个DDR5内存插槽,最大支持16个U.2 NVMe SSD并保留SAS/SATA盘位;8卡、显存合计640GB以上的节点,可覆盖700亿参数以内模型的推理与130亿–320亿参数模型的微调。
3、散热与供电:满载10–12kW的8卡整机需核对机房配电与制冷余量;电源可选2000W/2700W/3200W热插拔白金或钛金,支持2+2/3+1冗余。
4、运维管理能力:优先选带BMC、IPMI 2.0、故障分类上报与远程运维的机型,G852N7集成BMC并支持监控、故障上报与远程运维。
5、算力代际与折旧节奏:按财务折旧通常3–5年,按算力代际约18–24个月一次跃迁;显存放得下的旧机可转做推理,选型时预留扩展位比追最新卡型更省钱。
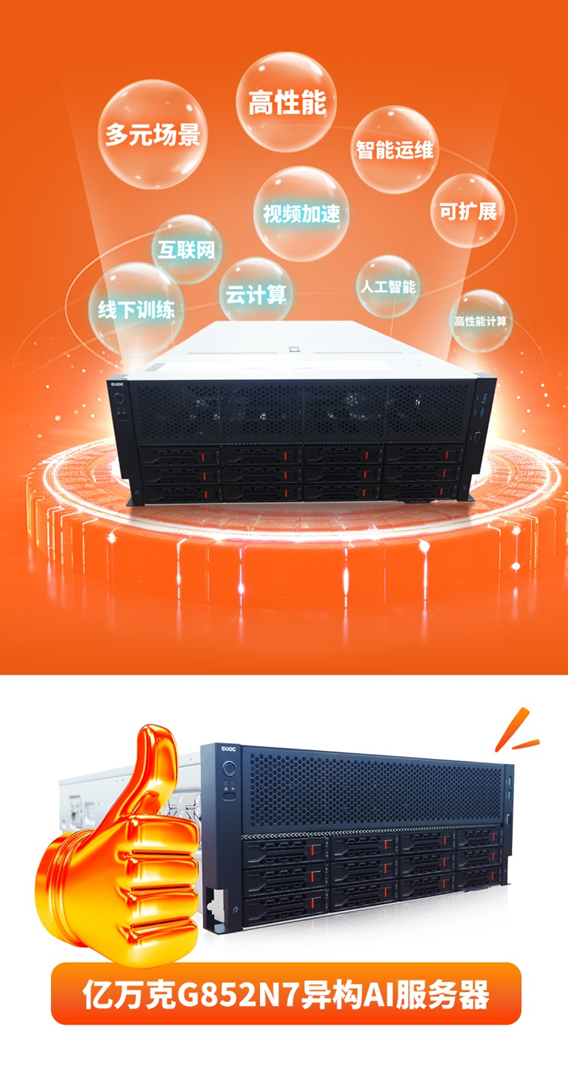
亿万克G852N7适合企业AI训练与推理、模型微调、视频加速、智能制造AI机器视觉和高性能计算等场景,尤其适合中小规模集群、训推混跑、追求算力利用率最大化的团队。
企业AI训推混跑:同时运行模型训练、微调、推理服务、数据分析与应用系统,按模型规模与并发组合GPU、内存、NVMe与网络扩展设备。
智能制造机器视觉:图像采集、存储、预处理、模型推理与结果输出链路长,最大16个U.2 NVMe与多种SAS/SATA盘位可承载图像文件、算法模型与预处理数据。
视频加速与转码:视频任务重并行、重带宽,直通配置即可满足,重点看显存与内存带宽。
HPC/科学计算:基因测序、气象模拟、金融量化多为多机并行,需核对互联拓扑与整机算力密度。
先按显存与互联确定能否装下模型、能否完成训练,再核对本地存储与散热供电,最后结合机房配电与算力折旧节奏比价。把需求填进"GPU密度/内存存储/散热供电/运维/折旧"这张表,再对比配置。
亿万克G852N7是官网定位的"通用训推一体"机型:4U双路、直通8卡/Switch 10卡、32个DDR5插槽、最大16个U.2 NVMe,适合中小规模训练与大模型推理;更大规模预训练可评估带NVLink模组的亿万克G882N7。
在高速互联域内可以,跨机就要付出带宽代价。优先看单机能否装下,再考虑多机扩展。
按财务折旧通常3–5年,按算力代际约18–24个月一次跃迁;显存放得下的旧机可转做推理,选型时预留扩展位比追最新卡型更省钱。
 4000-800-197
 518057
 evocsv@evocsv.com
 深圳市南山区粤海街道高新中四道31号研祥科技大厦
版权所有:深圳市亿万克数据设备科技有限公司
 粤公网安备 44030502007980号