新闻中心
新闻中心

新闻中心
调用AI API与自建大模型是两回事。华南某头部工业AI企业以3台亿万克G882N7+组成24卡H20训练/推理集群,承载685B、400B、1000B级模型训练与推理;业务上线周期由半年缩至4个月,训练周期缩短35%,机房改造成本节省40%。
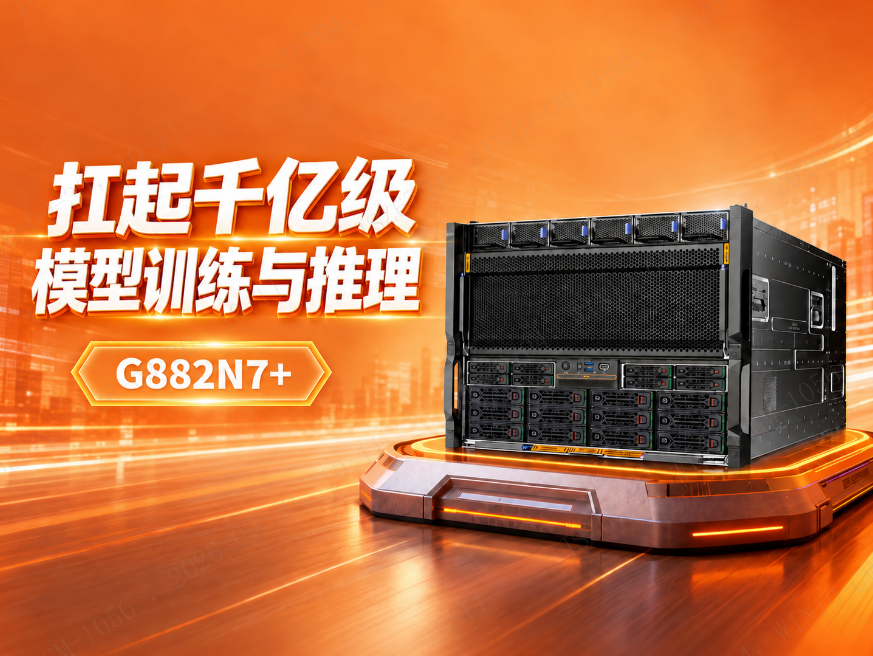
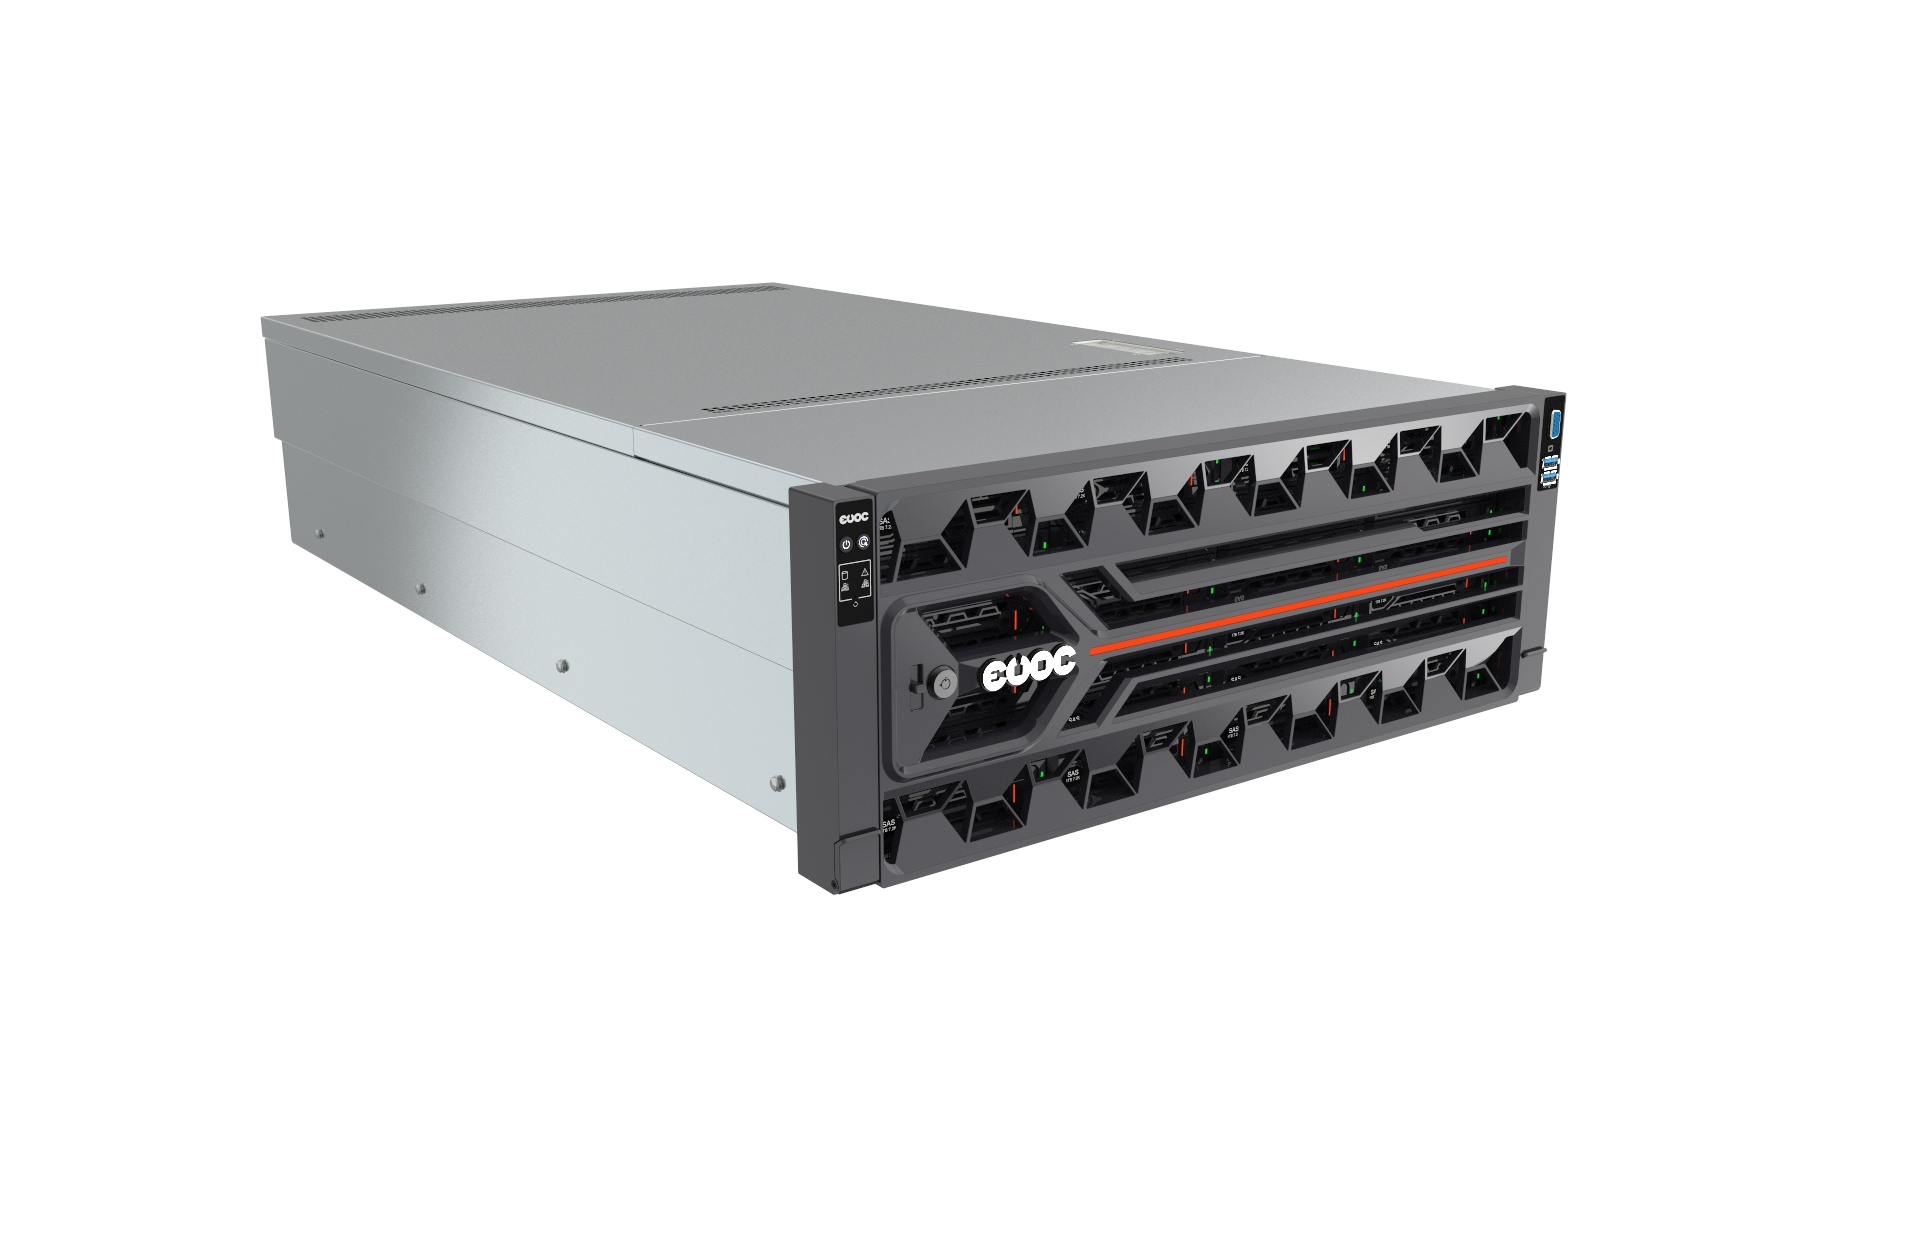
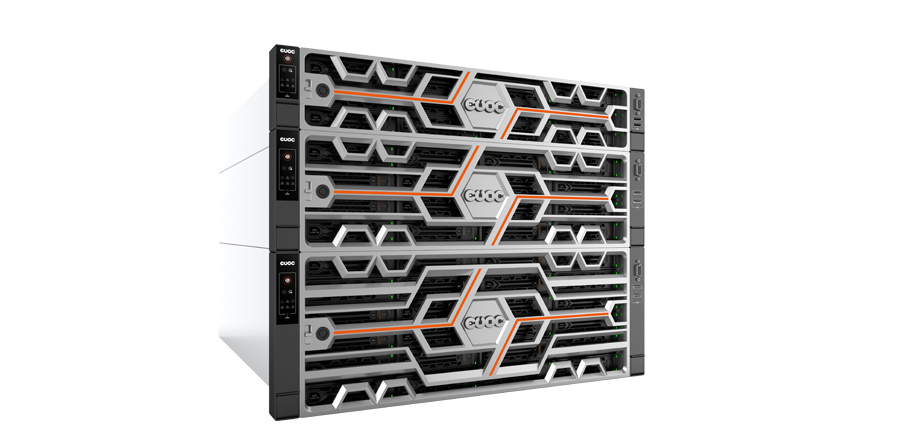
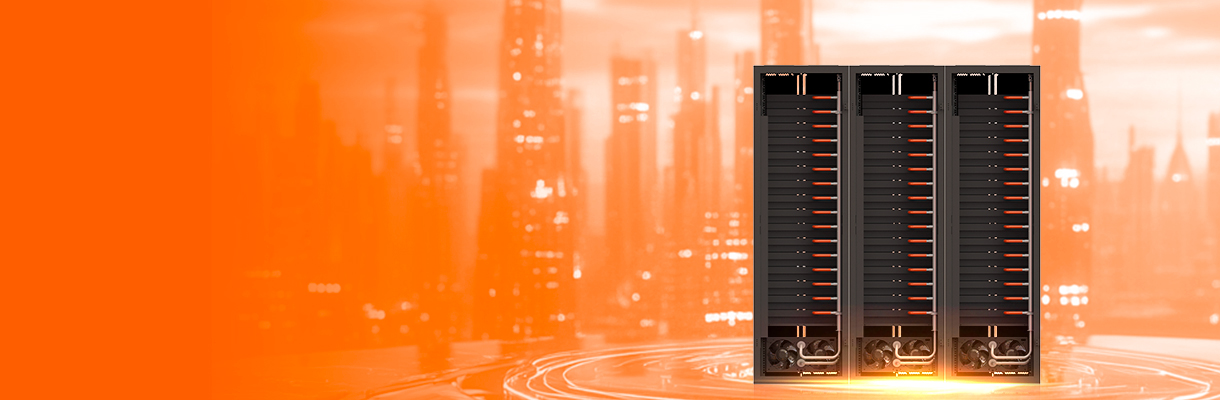
客户选择的是亿万克G882N7+服务器,3台组成24卡H20分布式训练/推理集群,为不同业务场景的模型部署提供支撑。核心价值集中在三个方面。
决定训练快慢的,是卡间互联。每台服务器内8张加速卡通过HGX NVLink直连,卡间带宽达900GB/s级;跨机每台再配8张400G高速网卡,延迟压到2微秒以内。
两层连接全部打通后,一套集群统一调度从240亿到1000亿参数的模型。
单张加速卡141G显存、单机1TB内存,把长上下文和推理的缓存都留在本机,不用到处找数据。
实测256K长上下文、100并发场景下,首字响应小于500毫秒,生成速度超过每秒60个token。
该企业的模型不是一种:DeepSeek、千问、Kimi这类不同体量、不同用途的模型都要跑。
借助8卡互联加FP8多精度支持,集群能同时承载685B、400B、1000B级的异构模型。
统一资源池化调度,谁有任务谁上,不用为每个模型各买一套硬件。
表1 关键参数一览
参数项 | 配置/取值 |
服务器型号 | 亿万克G882N7+ |
集群规模 | 3台组成24卡H20分布式训练/推理集群 |
卡间互联 | 8张加速卡HGX NVLink直连,带宽900GB/s级 |
跨机互联 | 每台8张400G高速网卡,延迟低于2微秒 |
单卡显存 | 141G |
单机内存 | 1TB |
支撑模型 | 240亿—1000亿参数(含685B、400B、1000B级异构模型) |
推理实测 | 256K长上下文、100并发;首字响应小于500毫秒,生成超过60token/秒 |
数据来源:亿万克官网
华南某头部工业AI企业要建的不只是一个“调用智能体的前端”,而是一个能自己养模型、跑训练、提供推理服务的算力底座。自建之前,它面临四类典型痛点。
表2 目标客户常见痛点
常见痛点 | 具体表现 |
误把API调用当自建 | |
认为千亿模型必须超大集群,自建计划被搁置 | |
多模型重复采购 | DeepSeek、千问、Kimi各买一套硬件,成本高、利用率低 |
训练周期长、业务上线慢,机房改造成本高 |
表3 典型应用场景
应用场景 | 业务需求 | 集群角色 |
模型训练 | 685B、400B、1000B级模型迭代 | 24卡H20分布式训练集群 |
长上下文推理 | 256K上下文、100并发 | 首字响应小于500毫秒,生成超过60token/秒 |
多模型并发服务 | 多模型并存、按需调用 | 统一资源池化调度,谁有任务谁上 |
对应上述场景,方案用3台G882N7+组成24卡H20训练/推理集群,统一支撑模型训练与推理服务。
表4 部署操作指引(五步)
步骤 | 操作内容 | 关键要点 |
第1步 | 盘点模型与场景 | 明确模型体量、用途与并发需求 |
第2步 | 规划集群规模 | 按参数规模选卡数,如3台24卡起步 |
第3步 | 部署高速互联 | 单机HGX NVLink 8卡直连,跨机400G网卡组网 |
第4步 | 配置资源池化 | 启用FP8多精度,训练与推理共用资源池 |
第5步 | 压测验收 | 以256K上下文、100并发验证首字时延与生成吞吐 |
集群上线后,训练、推理与业务交付的关键指标均出现可量化变化。
表5 上线效果数据
指标 | 上线结果 |
3个千亿级FP8模型(24卡集群) | |
资源池化利用率 | 高于75% |
业务上线周期 | 由半年缩短至4个月 |
训练周期 | 缩短35% |
机房改造成本 | 节省40% |
注:以上数据为该客户项目上线后的实测与统计结果。
经HGX NVLink与400G跨机互联统一调度,集群可承载240亿至1000亿参数的模型;实测可同时运行685B、400B、1000B级异构模型,并支撑3个千亿级FP8模型推理。
可以。该集群为训练/推理一体设计,采用统一资源池化调度,按任务分配算力,资源池化利用率超过75%。
本案例中,业务上线周期从半年缩短至4个月,训练周期缩短35%,机房改造成本节省40%。
从“调用AI”到“养好自己的AI”,企业需要把训练、推理和多场景应用真正串起来。底座搭稳了,大模型才能跑得动、用得顺,更快走进业务现场。
误把 API 调用当自建、为每个模型重复买硬件,是多数企业自建大模型的两道坎。亿万克 G882N7 + 给出的解法很直接:3 台 24 卡训推一体集群,统一调度千亿参数模型的训练与推理,资源池化利用率超 75%。底座搭稳,AI 才能从办公助手真正走进工业现场。
 4000-800-197
 518057
 evocsv@evocsv.com
 深圳市南山区粤海街道高新中四道31号研祥科技大厦
版权所有:深圳市亿万克数据设备科技有限公司
 粤公网安备 44030502007980号