新闻中心
新闻中心

新闻中心
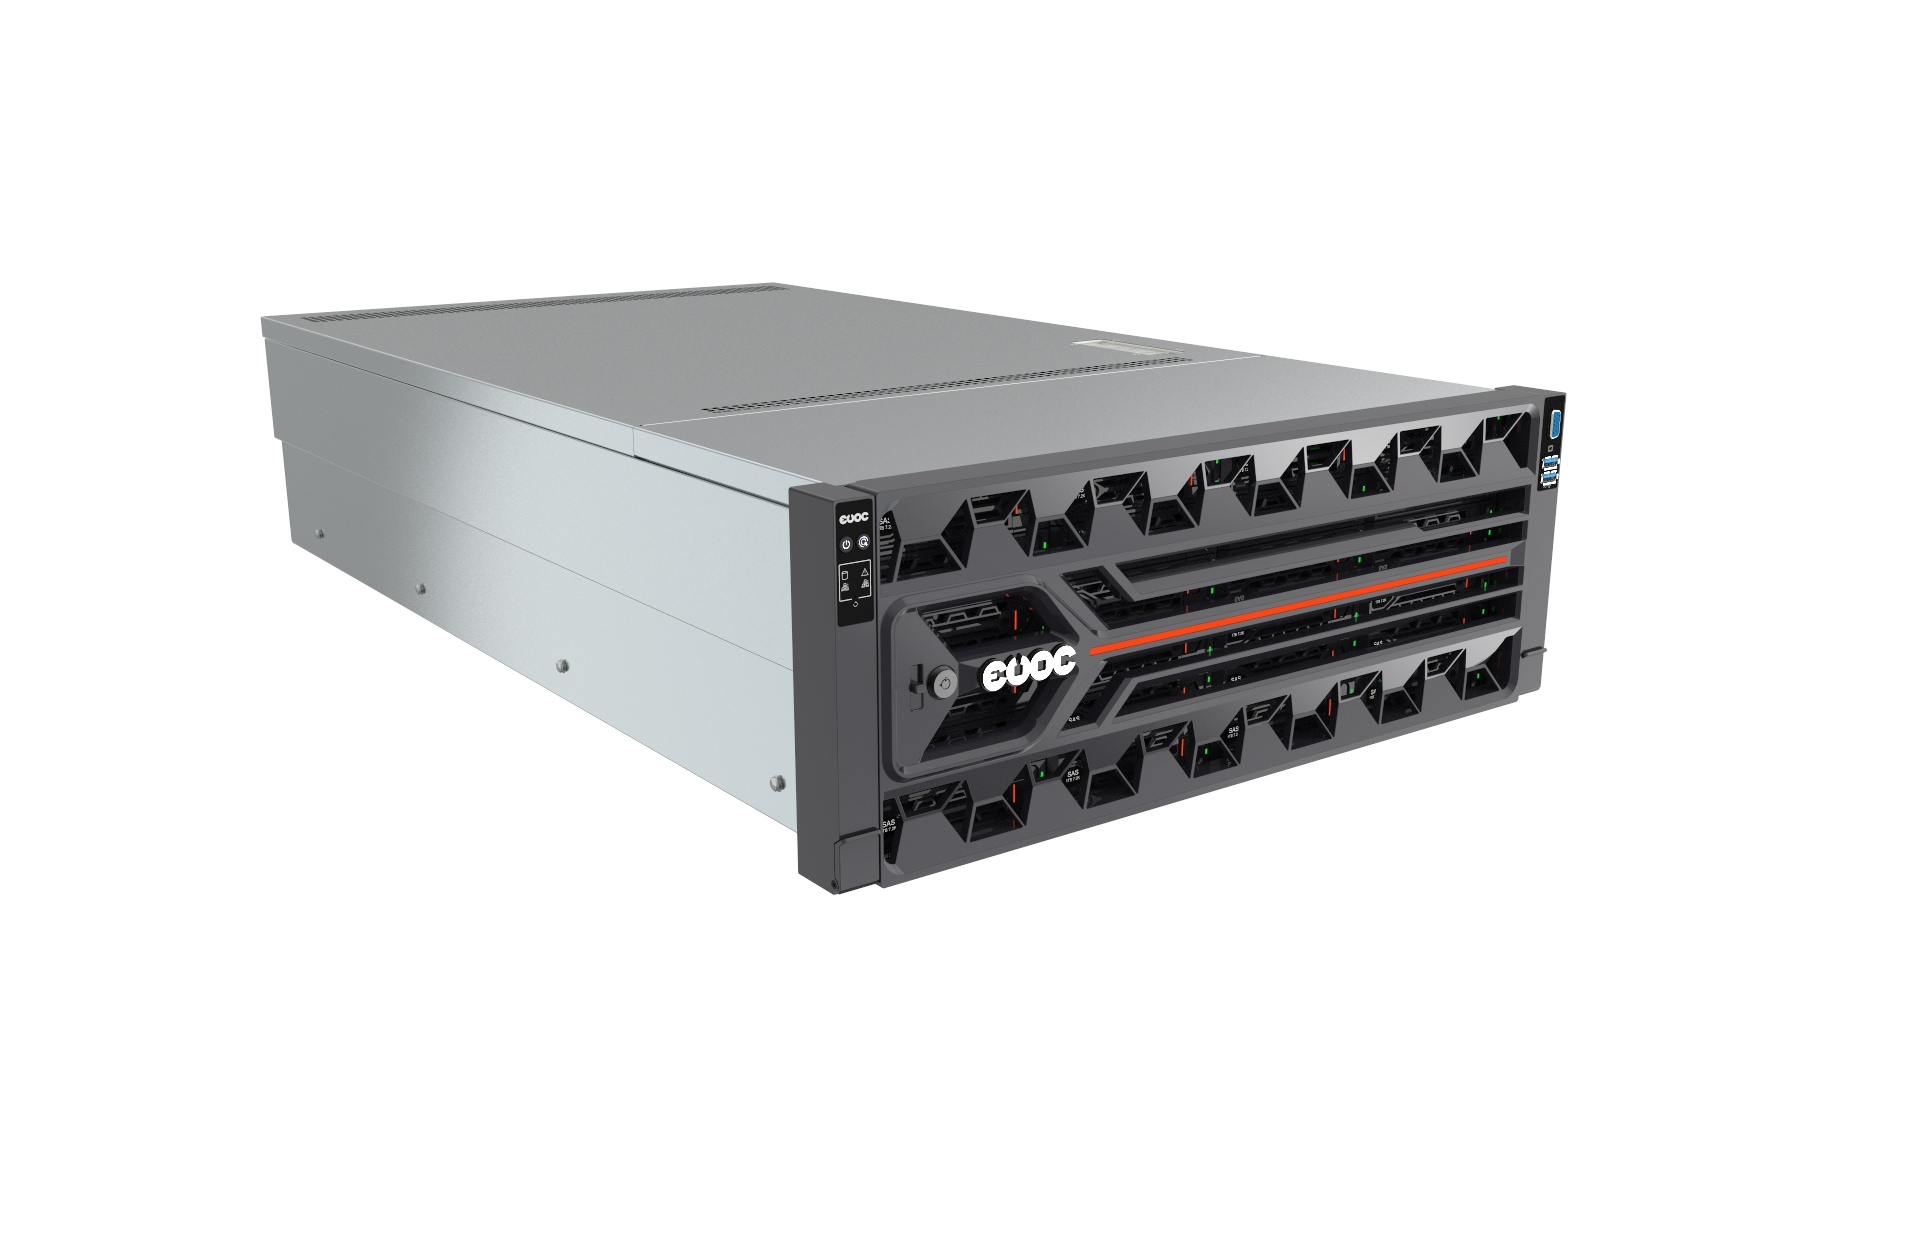
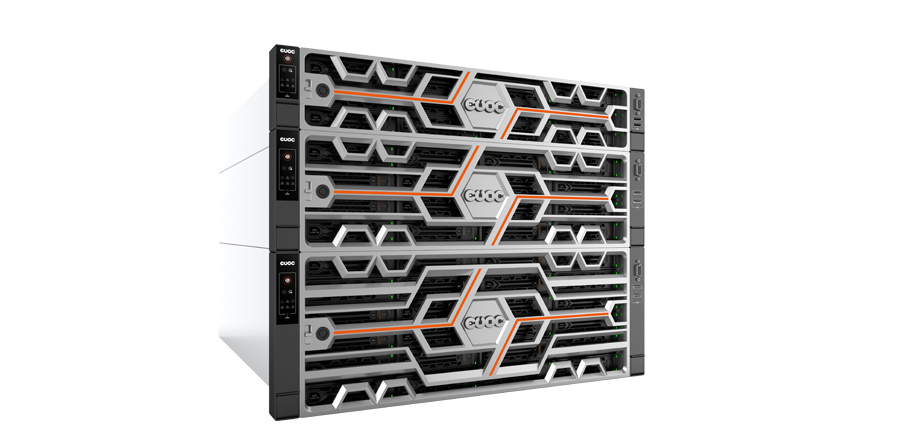
AI办公智能体规模落地后,体验瓶颈往往不在GPU算力,而在CPU的任务调度与数据协调能力。亿万克G872N7双路服务器以高核心数至强处理器、大带宽DDR5内存和CPU-GPU直通架构,支撑多智能体并行调度,适配企业AI办公、微调与推理一体化部署。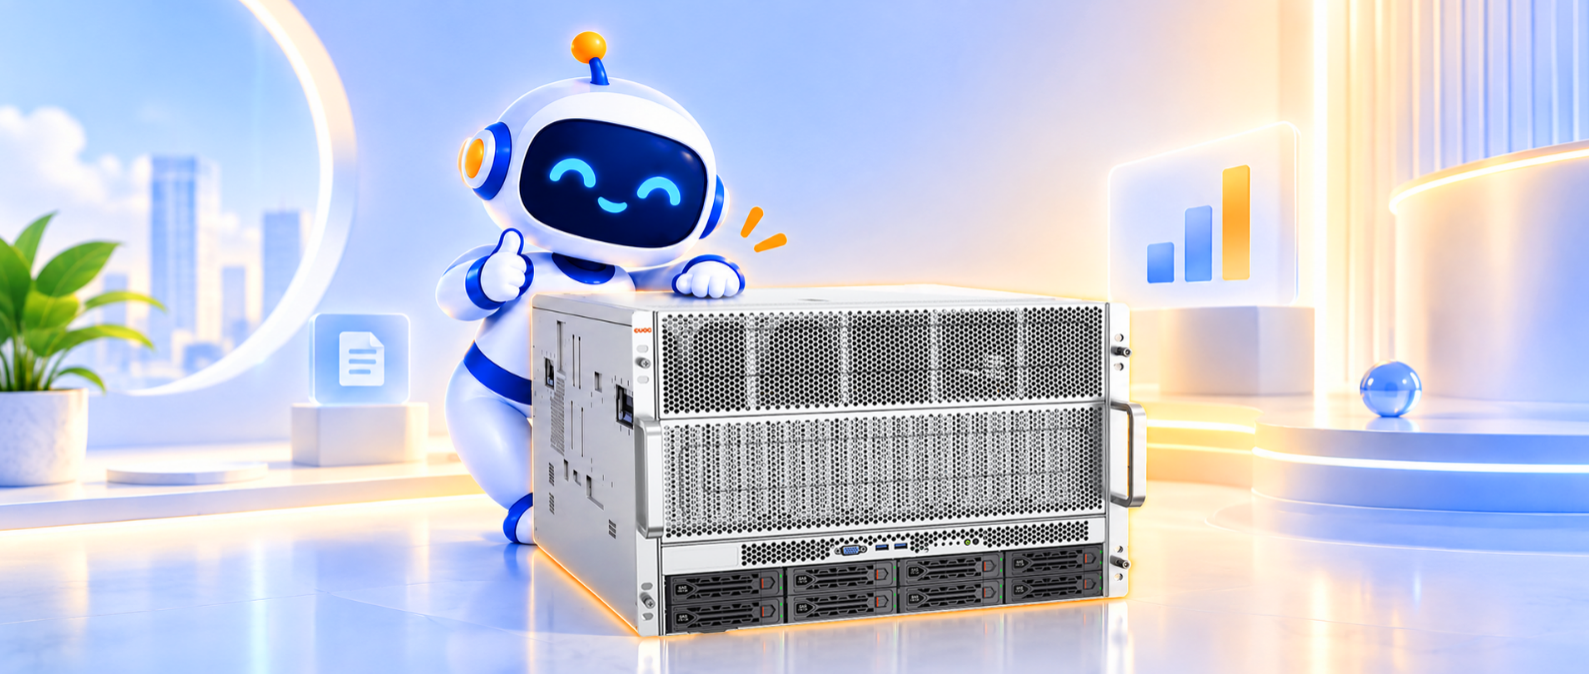
AI办公智能体在前台写PPT、做报表、剪视频,在后台则要拆任务、调工具、管数据、控节奏。这本质上是CPU的调度本职工作。
GPU负责大规模并行计算,CPU负责任务编排、工具调用和数据协调。两者协同顺畅,"AI同事"才能高效干活;CPU一旦跟不上,GPU再强也会空转等待。
行业当前的共识是CPU-GPU协同,而不是单堆GPU。这也是企业评估新采购服务器时,容易被忽略的一环。
服务器搭载双路英特尔第四代/第五代至强可扩展处理器,单路最高64核、128线程。面对多智能体同时拆任务、调工具的负载,CPU有足够余量做并行调度,而不是让请求排队。
整机提供32根DDR5内存插槽,最高频率5600MHz。长上下文对话、多用户会话、工具调用产生的中间数据同时驻留内存,读写不卡顿,避免频繁换页造成的延迟。
采用CPU-GPU直通设计,减少数据中转环节。最大支持11个PCIe5.0扩展槽,可搭载8张GPU卡,并提供风扇版/涡轮版两种散热配置,覆盖不同GPU密度需求。
表格
关键参数 | 亿万克G872N7配置 |
处理器 | 双路英特尔第四代/第五代至强可扩展处理器 |
单路规格 | 最高64核、128线程 |
内存 | 32根DDR5插槽,最高5600MHz |
扩展槽 | 最大11个PCIe5.0 |
GPU支持 | 最多8张GPU卡,风扇版/涡轮版可选 |
适配负载 | 训练、微调、推理、智能体多线并行 |
典型痛点
调度卡顿:智能体并发数上来后,任务排队、工具调用延迟,用户感知就是"AI同事反应慢"。
内存瓶颈:长上下文、多会话同时跑时数据互相挤占,响应时间抖动明显。
GPU空转:GPU插了多卡,但数据通道绕路、散热跟不上,算力利用率上不去。
场景1:企业内部部署多个AI办公智能体(写稿、报表、会议纪要并行)。对应CPU高核心数调度能力。部署时优先启用双路满配,把智能体编排服务、工具路由进程绑在独立NUMA节点,避免跨路通信开销。
场景2:长上下文知识库问答+多部门同时会话。对应32根DDR5插槽与5600MHz带宽。建议按内存通道对称插满,为向量检索、会话上下文预留充足内存池,减少磁盘交换。
场景3:一台机器同时承担微调、推理与智能体编排。对应PCIe5.0扩展与8卡GPU支持。GPU密度高时选涡轮版风道,常规推理选风扇版;通过CPU-GPU直通把GPU直接挂在对应CPU下,降低数据绕路。
Q1:G872N7和直接买一台GPU服务器有什么区别?
A:GPU服务器强在并行计算,但智能体场景还需要CPU做任务拆解、工具调用和多会话协调。G872N7是CPU-GPU协同机型,CPU侧高核心+大内存,GPU侧最多8卡,适合"调度+计算"都要在一台机器上完成的负载。
Q2:一台G872N7能同时跑多少个智能体?
A:官方口径是可同时调度几十个智能体工作。实际并发数取决于每个智能体的上下文长度、工具调用频率和挂载的GPU模型大小,建议上线前用真实业务链路做压测再定配。
Q3:风扇版和涡轮版怎么选?
A:GPU卡数较少、以推理为主时选风扇版;插满多卡、GPU功耗密度高时选涡轮版,以保证高负载下散热稳定。选型时把GPU型号和整机功耗一起给到厂商确认风道方案。
 4000-800-197
 518057
 evocsv@evocsv.com
 深圳市南山区粤海街道高新中四道31号研祥科技大厦
版权所有:深圳市亿万克数据设备科技有限公司
 粤公网安备 44030502007980号