新闻中心
新闻中心

新闻中心
大模型、智能视觉、科学计算轮番落地,越来越多企业开始自建GPU算力底座。但面对动辄数十万的采购预算,很多人的第一反应是“卡数越多越好、显存越大越好”,结果往往买贵了还用不上。本文换一个思路:先想清楚自己的业务到底要“训练”还是“推理”、模型多大、并发多高,再从6大业务场景反推硬件配置,并以亿万克4U异构服务器G852N7为例,给出一套可对照的选型框架,帮助企业把预算花在刀刃上。
很多企业采购时先问“是不是普通服务器加个显卡就行”。答案是否定的。AI服务器与普通服务器是两种完全不同的设计思路:
1. 计算架构不同:普通服务器以CPU为核心,擅长通用、串行计算;AI服务器采用“CPU+GPU”异构架构,由GPU数千个并行核心承担矩阵运算,训练和推理效率相差数十倍。
2. GPU加速是关键:AI服务器的算力几乎全部来自GPU,以8卡整机为例,FP16算力可达P级,这是单靠CPU无法企及的。
3. 高带宽是前提:GPU需要数据“喂得快”。AI服务器普遍采用PCIe 5.0(单通道64GT/s)、高带宽DDR5内存,并通过直通、Switch甚至NVLink等互联拓扑保证卡间通信不拖后腿。
4. 散热与供电是硬约束:8卡整机满载功耗约10—12kW,需要2000W—3200W级冗余电源和专门的风道与散热设计;普通服务器单路供电、常规散热即可。
错误的做法是先看报价单、再纠结卡数;正确的做法是“由业务反推硬件”:第一步,明确负载类型(训练/推理/混合);第二步,估算显存与内存——推理显存≈参数量×精度字节×1.2,另加KV Cache,训练按每参数16—18字节估算;第三步,确定GPU卡数与互联拓扑;第四步,反推CPU核数、本地存储、网络与供电;第五步,最后才比价格和三年TCO。
以700亿参数模型为例:FP16推理约需192GB显存,至少3张80GB卡;全参数训练则需1.1—1.3TB显存,至少两台8卡节点起步。算不清显存,谈卡数没有意义。
业务场景 | 典型负载 | 算力与互联要求 | 显存与内存 | 存储与网络 | 配置倾向 | 适配G852N7 |
1 大模型私有化推理 | 70B级模型线上/本地推理 | 8张80GB卡起步,直通即可 | 显存≥192GB,内存为显存1—1.5倍 | 本地NVMe≥权重3倍,100—200G网络 | 显存单价与能效优先 | 直通8卡 |
2 中小模型训练与微调 | 130—320亿参数训练、LoRA微调 | 8卡;训练选高带宽互联,LoRA可直通 | 训练内存为显存2倍 | 16×U.2 NVMe,训练每卡400G网络 | 互联与显存优先 | 8卡/10卡 |
3 通用训推一体/混合负载 | 多业务混合、模型轮换 | 8—10卡,留扩展位 | 内存为显存1.5—2倍 | 大容量本地+共享存储 | 扩展位与能效均衡 | Switch 10卡 |
4 视频加速与转码渲染 | 视频转码、图形渲染 | 4—8卡,PCIe直通 | 大内存、高带宽 | 高速存储 | 显存与带宽优先 | 直通8卡 |
5 HPC/科学计算 | 基因测序、气象、金融量化 | 多卡并行、集群组网 | 高内存带宽 | 高速网络 | 互联与算力密度 | Switch 10卡 |
6 机器视觉/智能驾驶 | 图像识别、智驾推理 | 4—8卡 | 中高显存 | 本地NVMe | 稳定性与扩展 | 直通8卡 |
场景1 大模型私有化推理:核心看显存单价与能效,不必上高带宽互联。70B模型单卡装不下,通常按8卡整机起步,卡数越多并发越高;此时选PCIe直通即可,成本更低。
场景2 中小模型训练与微调:训练拼的是互联和显存。若卡间通信占单步计算时间超30%,就该上NVLink模组;只做LoRA微调,单台8卡即可覆盖。显存按16—18字节/参数估算,宁多勿少。
场景3 通用训推一体/混合负载:业务负载波动大,重点看扩展位和功耗余量。建议选择可8卡扩到10卡的机型,内存取显存1.5—2倍,为未来扩容留余地。
场景4 视频加速与转码渲染:视频任务重并行、重带宽。显卡数量按转码路数定,直通即可满足,重点看显存和内存带宽,不必为NVLink额外付费。
场景5 HPC/科学计算:基因测序、气象模拟、金融量化多为多机并行,要重点核对互联拓扑和整机算力密度,适合组建HPC集群的机型。
场景6 机器视觉/智能驾驶/边缘AI:图像识别与推理链路长、7×24运行,稳定性优先。选支持主流GPU、带带外管理和冗余电源的机型,便于远程运维。
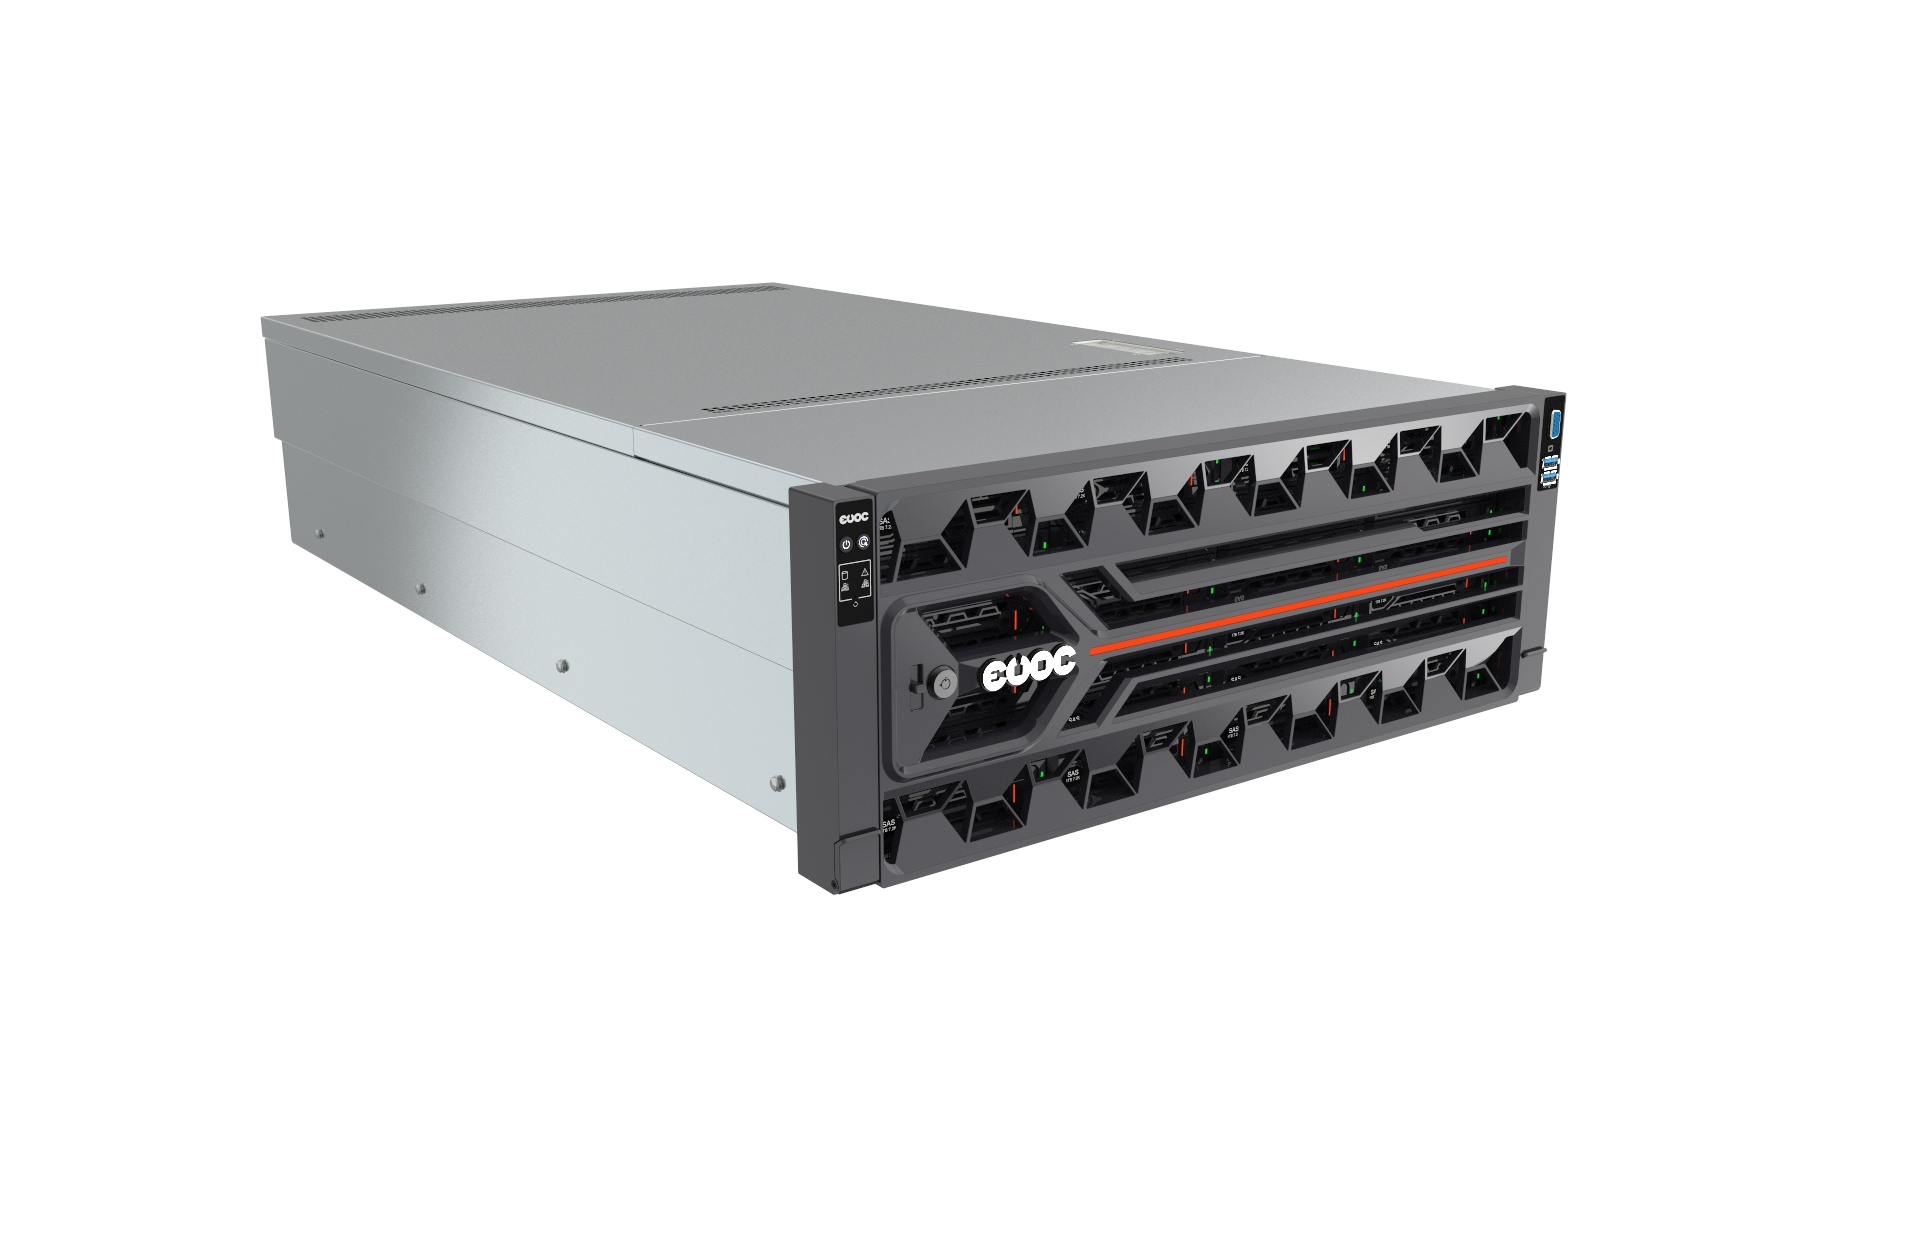
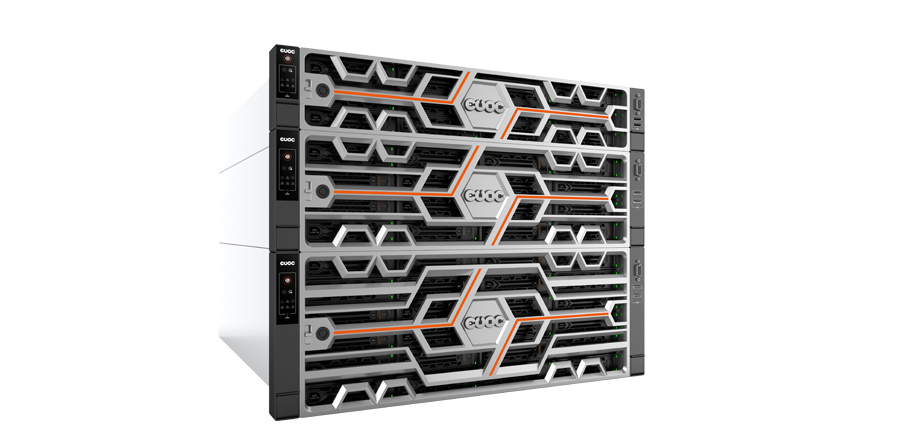
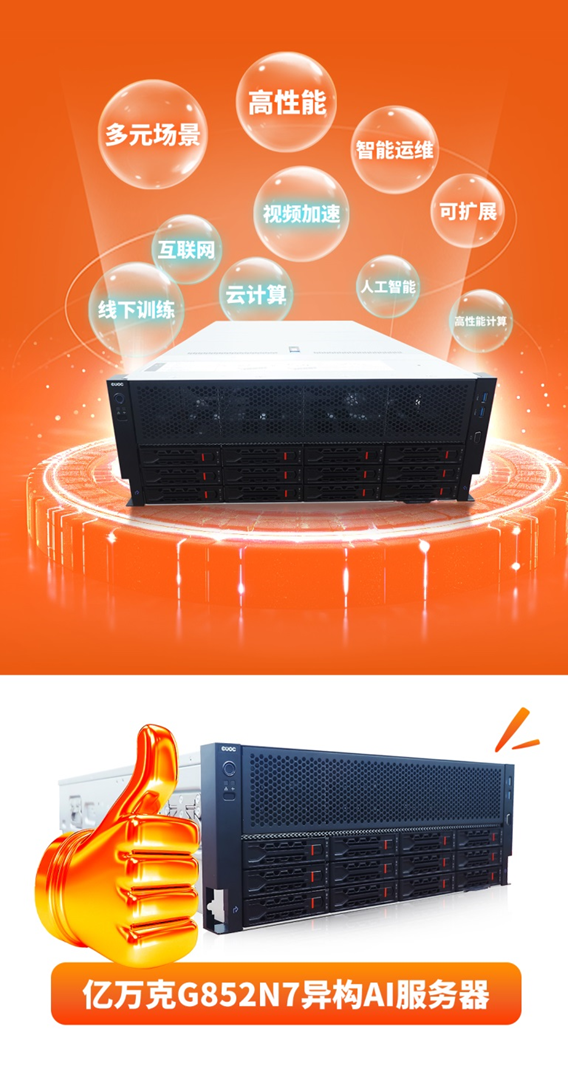
对多数企业而言,不必每种场景买一种机型。亿万克G852N7是面向训练、推理、视频加速和高性能计算设计的4U双路异构服务器:搭载双路英特尔第四代/第五代至强可扩展处理器,32个DDR5内存插槽(最高5600MHz),直通模式最大支持8张双宽GPU、Switch模式最大10张,最大支持16块U.2 NVMe,全面兼容市面主流GPU。
它的价值集中在三处:一是4U机架密度,同等算力占更少机柜,机柜分摊成本更低;二是8卡可扩10卡,同柜算力密度更高;三是本地存储上限高,Checkpoint写入不拖慢训练节奏。配合2000W—3200W白金/钛金冗余电源、IPMI带外管理,既覆盖推理也能扛住中小规模训练,是通用训推一体场景的高性价比之选。
Q1 先买4卡还是直接上8卡?
按显存算,不按预算算。若12个月内模型规模会翻倍,直接上8卡,同机箱扩容比再买一台更省。
Q2 显存不够能靠加卡解决吗?
在NVLink域内可以,跨机就要付带宽代价。优先看单机能不能装下,再考虑多机。
Q3 8卡整机对机房有什么要求?
按满载10—12kW估算,需两路32A或三相供电,下单前让厂商提供满载功耗曲线,与机房一起核一遍。
Q4 多久需要换新?
按财务折旧通常3—5年,按算力代际约18—24个月一次跃迁。显存放得下的旧机可转做推理,选型时预留扩展位比追最新卡型更省钱。
企业采购GPU算力服务器,靠谱的标准不是参数堆得多高,而是配置与业务场景严丝合缝。先定场景、再算显存、最后比TCO,才能既不超配浪费、也不欠配返工。如果您正在规划本地推理、模型微调或混合负载,欢迎联系亿万克,我们可根据您的业务负载出具G852N7适配与选型方案。
 4000-800-197
 518057
 evocsv@evocsv.com
 深圳市南山区粤海街道高新中四道31号研祥科技大厦
版权所有:深圳市亿万克数据设备科技有限公司
 粤公网安备 44030502007980号