新闻中心
新闻中心

新闻中心
2026 年 AI 服务器市场同比增长 52%,但选型错误会导致几十万级硬件投入闲置。本文按「训练型、推理型、通用型」三类场景拆解选型标准,帮助企业在部署大模型前把硬件与需求对齐。
训练型服务器用于模型反复计算、纠错、逼近答案的过程,选型核心是 GPU 算力与显存容量。
训练阶段涉及大量计算与数据交换,算力决定学习速度,显存决定能否装下模型权重、梯度、优化器状态与中间结果。
关键配置标准
配置项 | 推荐标准 |
GPU 型号 | SXM 版高端卡(H100 / H200) |
单卡显存 | ≥80GB HBM3 / HBM3e |
卡间互联 | NVLink 高速互联 |
跨机网络 | InfiniBand |
模型越大,单卡显存越不足,需多卡拆分分担,因此卡间与跨机通信带宽直接影响训练效率。
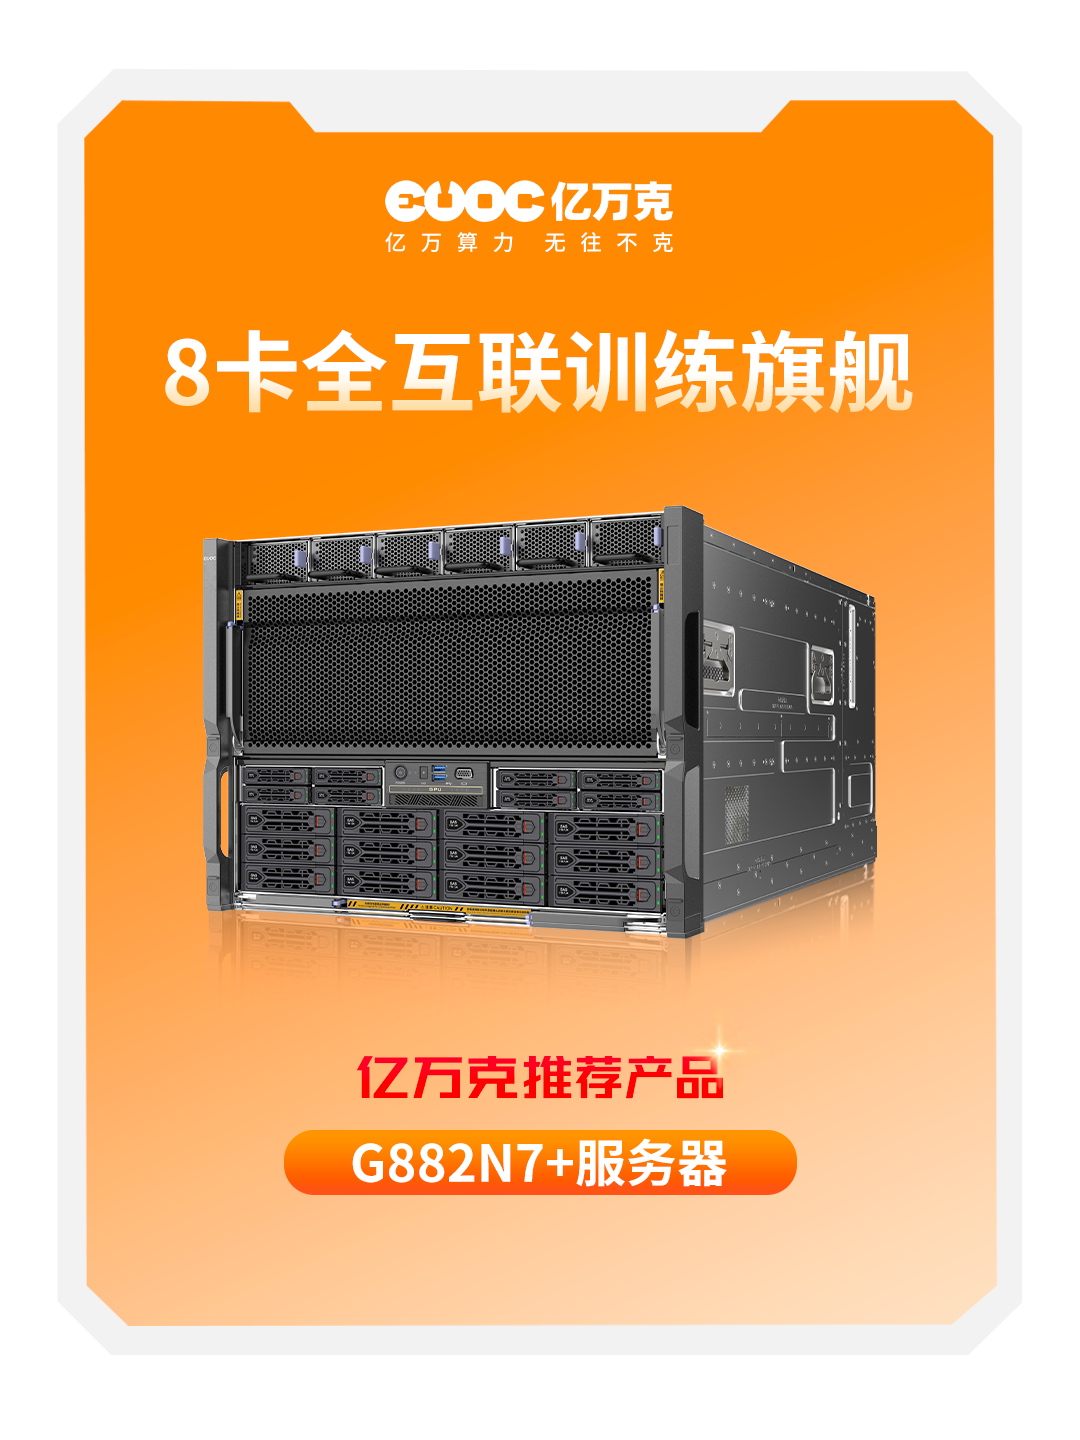
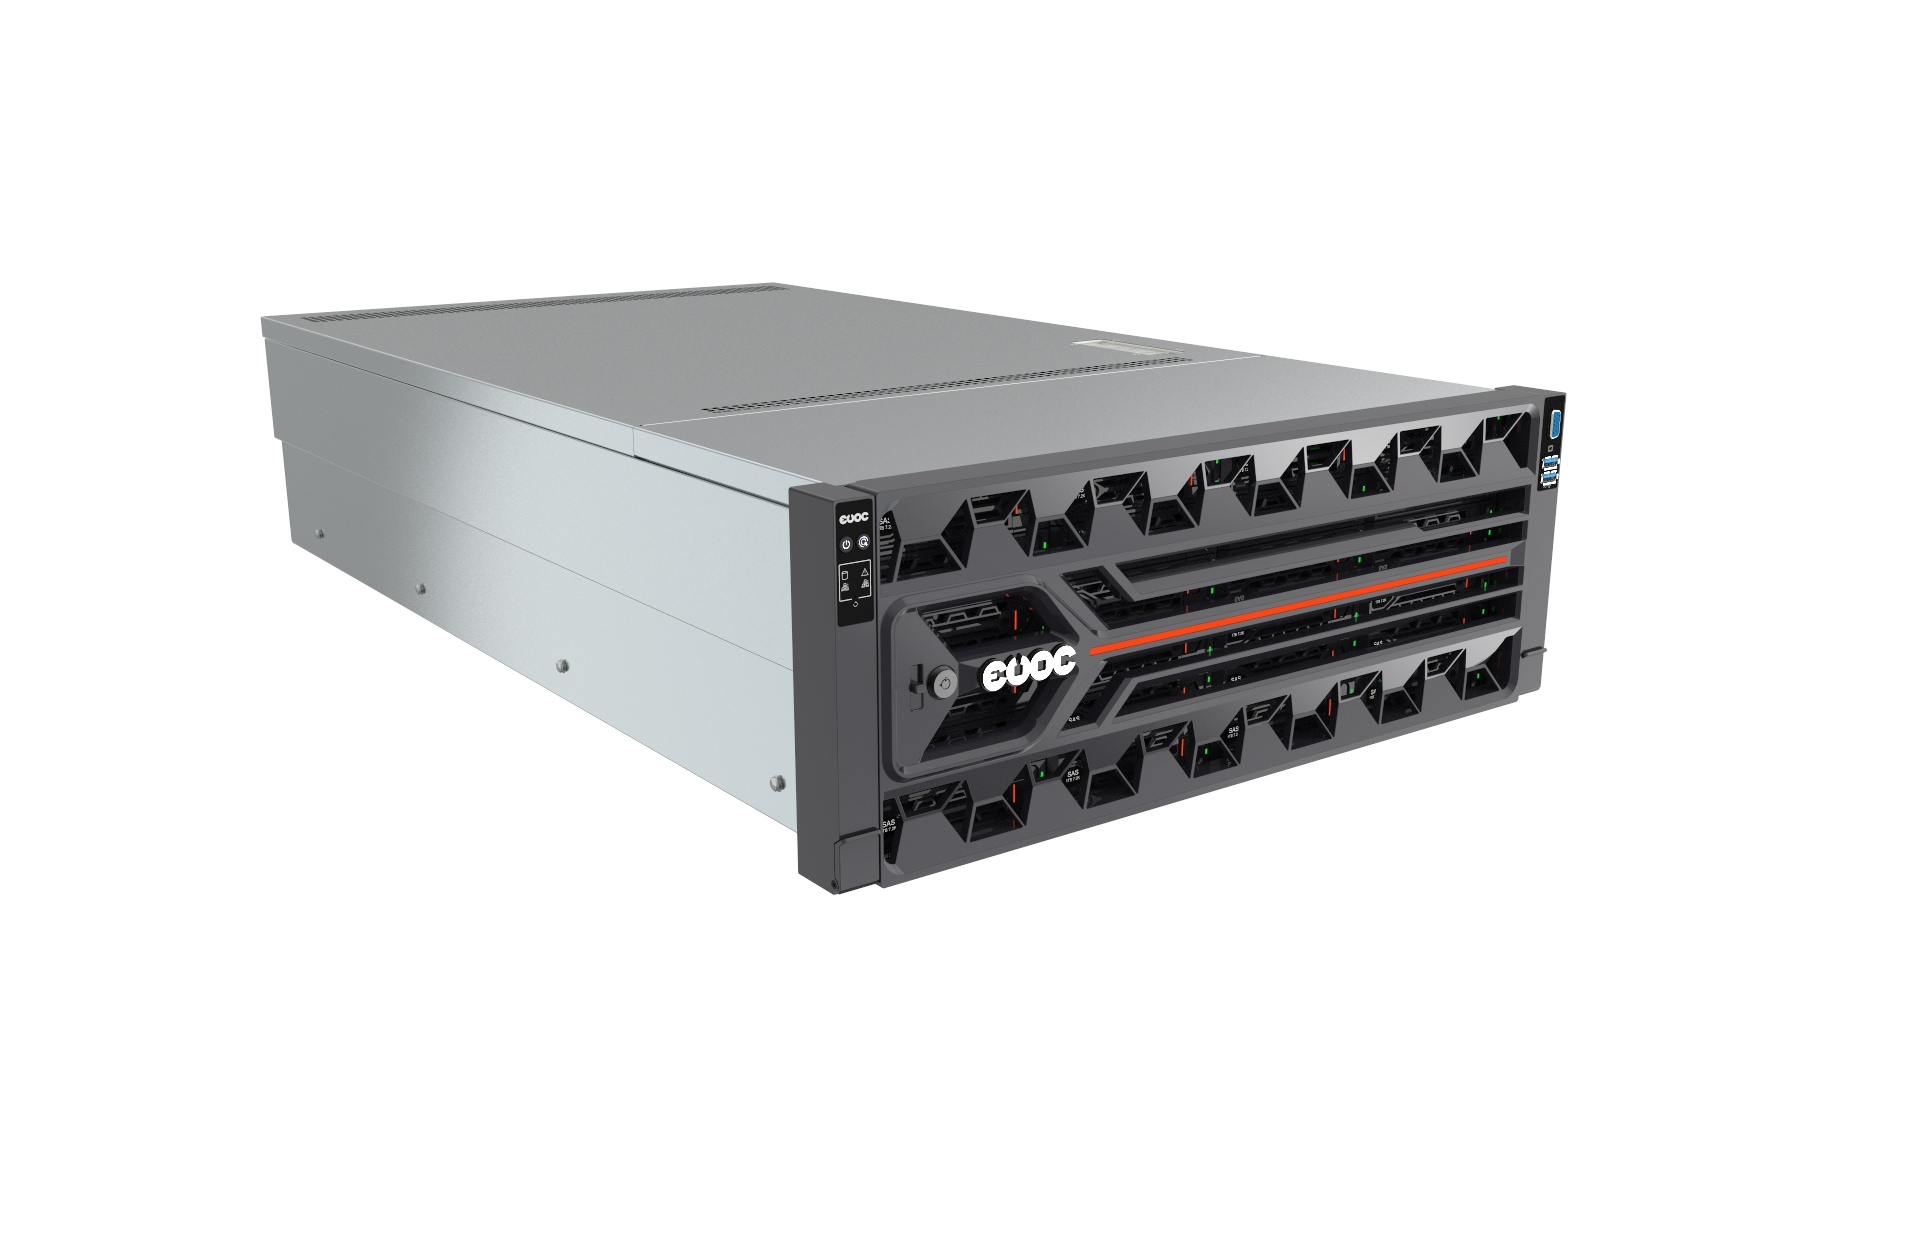
8U8 卡高密度:单机部署 8 张加速卡,支持 H100/H800/H20 NVLink 全互联,多卡协同训练无瓶颈;
双互联速通架构:CPU-Switch 支持双互联模式,可选 X32 或 X16 带宽互联,数据通路不拥堵。
推理型服务器承载模型生成答案的环节,核心指标是「每花一元钱能产出多少 token」,无需训练级别的卡间互联。
推理场景需按细分需求选择,不能一概而论:
场景类型 | 选型重点 |
高吞吐场景 | 优先算力强的加速卡,单机承载更多并发请求 |
长上下文推理 | 大显存 + 高带宽组合 |
业务敏感场景 | 国产算力方案,供应链自主可控 |
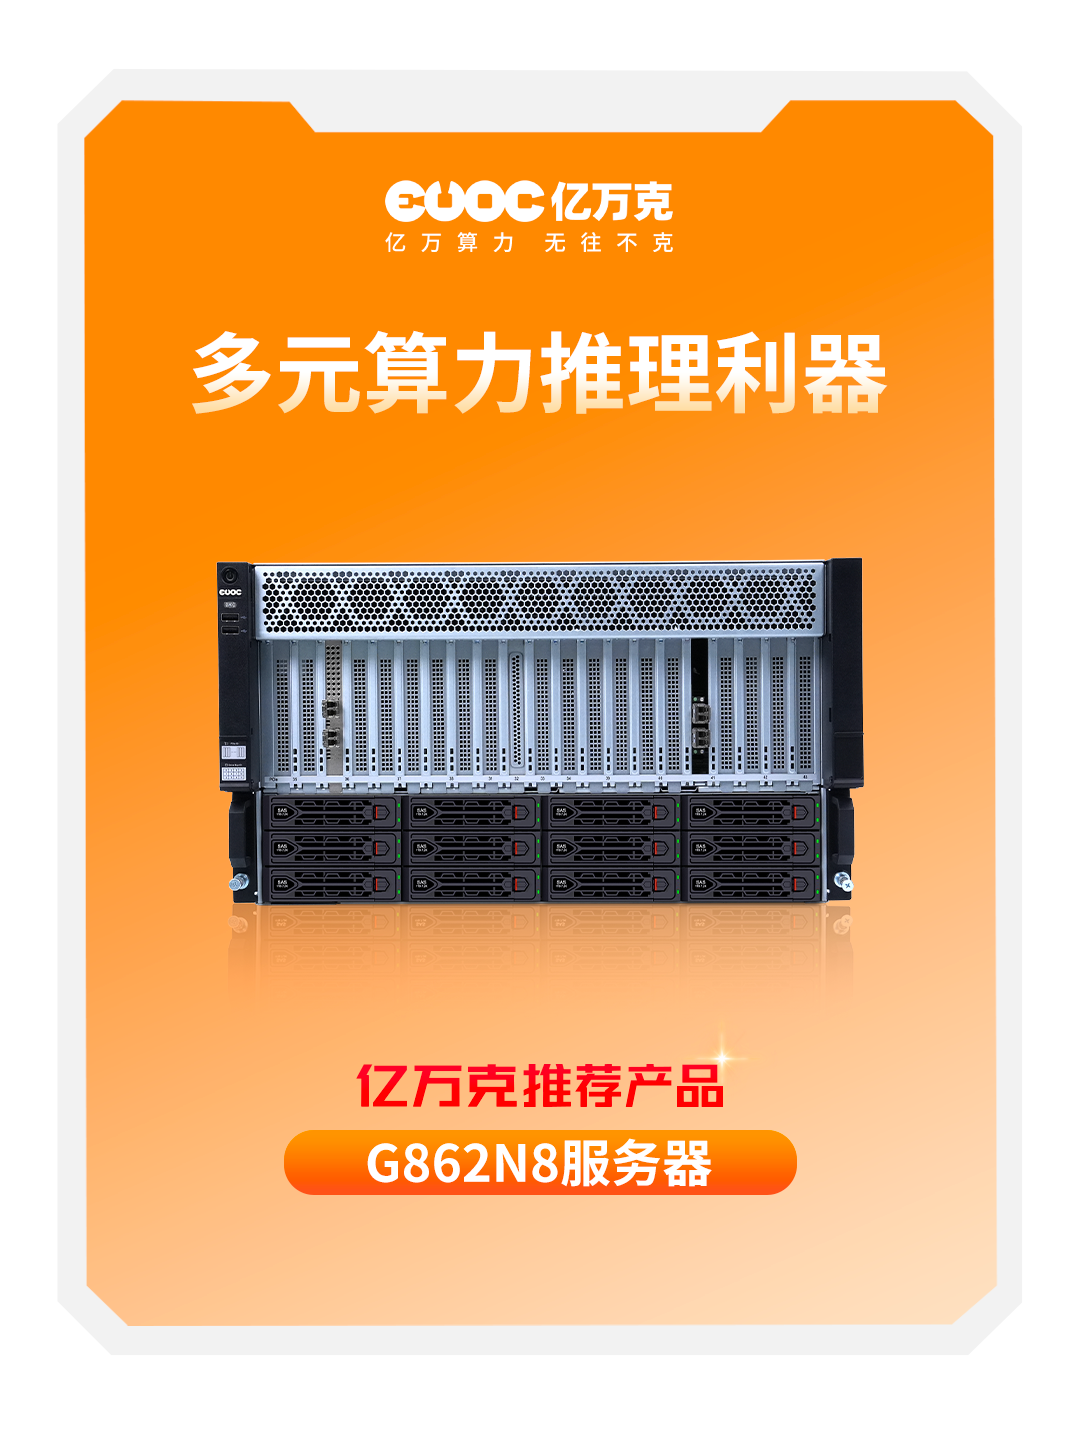
多元算力池化:单机搭载 8 张双宽/三宽/四宽 GPU,灵活适配多卡并行推理;
PCIe 5.0 全速通道:最多 13 个 PCIe x16 + 1 个 OCP 3.0 扩展槽;
大容量高带宽:32 根 DDR5,支持 MCR DIMM(8000MT/s)、RDIMM(6400MT/s),应对长上下文并发。
通用型服务器面向文档解析、数据清洗、知识库检索、数据库访问、业务系统对接等轻量环节,配置重点是 CPU、内存、存储与 I/O 均衡。
这些环节若使用训练或推理服务器会浪费成本,通用型服务器更适合轻量推理与开发测试两大需求。
推荐配置
配置项 | 标准 |
CPU | 2 路 Xeon / EPYC |
内存 | 12–24 根 DDR5 |
盘位 | 8–24 盘位 |
网卡 | 双口 10/25G |
以上配置可覆盖多数 7B/13B 量化模型的 CPU 推理、小 GPU 推理、模型微调、RAG、边缘部署等场景。
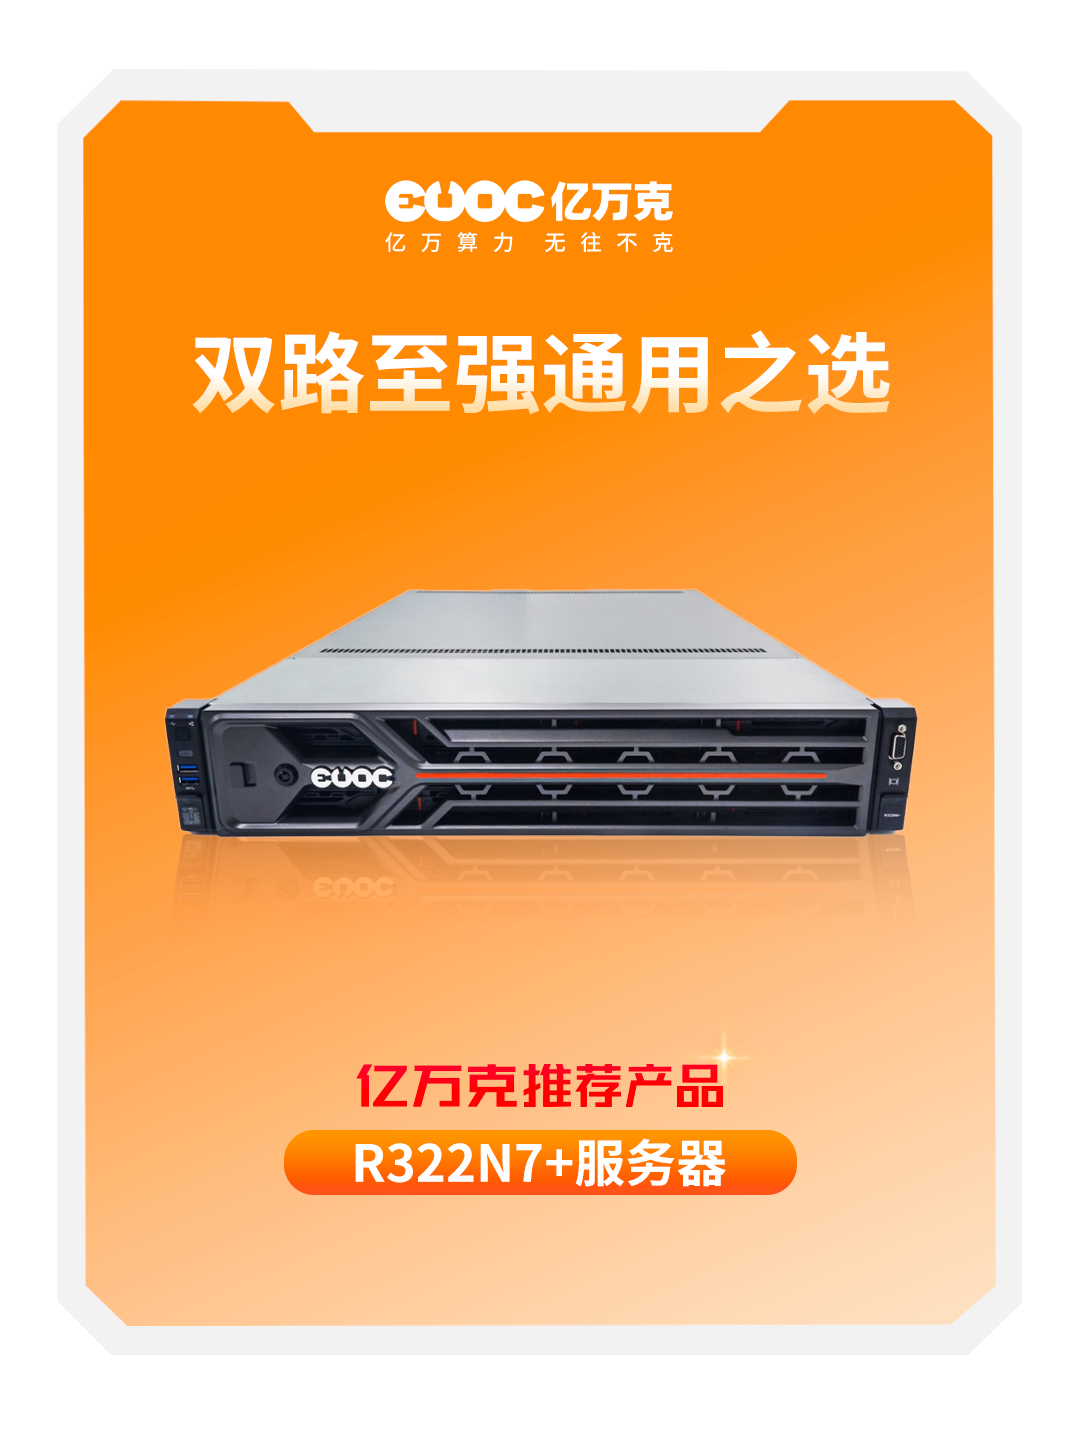
双路通用 CPU:搭载 2 颗 Intel 第四代/第五代至强可扩展处理器,单 CPU 最高 64 核 128 线程;
灵活扩展:最多 8 个 PCIe 5.0 扩展槽,可扩展 4 张双宽 GPU。
1. 先定任务:明确模型、精度、上下文长度,以及训练方式或推理并发。
2. 再排优先级:训练看计算与协同效率,推理看服务体验与单位成本,通用业务看资源均衡与扩展能力。
3. 最后实测:用真实模型和业务数据验证速度、稳定性、功耗及成本。
Q1:部署大模型一定要用训练型服务器吗?
不需要。训练型服务器用于模型训练,若企业仅调用现成模型做推理,应选推理型服务器,单位 token 成本更低,无需训练级卡间互联。
Q2:长文本问答场景应优先提升哪项配置?
优先提升显存与带宽。大显存才能装入长上下文,高带宽才能保证答案快速输出,可参考 G862N8 的 32 根 DDR5 与大容量显存组合。
Q3:轻量业务(文档解析、RAG)如何避免过度配置?
选用通用型服务器。2 路至强 CPU + 12–24 根 DDR5 + 双口 10/25G 网卡即可覆盖多数 7B/13B 量化模型场景,无需训练或推理级硬件。
 4000-800-197
 518057
 evocsv@evocsv.com
 深圳市南山区粤海街道高新中四道31号研祥科技大厦
版权所有:深圳市亿万克数据设备科技有限公司
 粤公网安备 44030502007980号