新闻中心
新闻中心

新闻中心
摘要:AI服务器选型要核对 7 类核心参数,其中 GPU 卡型与互联拓扑、显存与内存容量三项决定模型能不能跑起来,其余各项决定三年用下来贵不贵、稳不稳。本文给出每项参数的判定阈值与核验方式,并以亿万克六款 AI 服务器(G882N7+、G852N7、G862N8、G852N6、G552N6、G852A7)作对照实例。
AI服务器选型共 7 项核心参数:GPU 卡型与互联拓扑、GPU 数量与扩展方式、CPU 与配比、显存与内存、本地存储、集群网络、可靠性与服务。先核前三项,再谈价格。
| 参数 | 判定阈值与核验方式 | 亿万克机型实例 |
| GPU 卡型与互联拓扑 | 训练选 NVLink 模组,推理可用 PCIe 直通;向厂商要整机拓扑图 | G882N7+ 支持 1 个 H100/H800/H20 NVLink 模组 |
| GPU 数量与扩展 | 直通最多 8 卡,Switch 可到 10 张以上 | G852N7 直通 8 卡、Switch 10 卡 |
| CPU 与配比 | 训练每卡 16–32 物理核,核对 PCIe 通道总数 | G862N8 支持 2 颗第六代英特尔®至强®可扩展处理器 |
| 显存与内存 | 内存 ≥ 显存总量 ×2(训练);插槽 ≥32 留扩容余量 | 三款均 32 个 DDR5 插槽,G862N8 支持 MCR DIMM 8000MT/s |
| 本地存储 | 本地 NVMe ≥ 模型权重 ×3 | G852N7 最大支持 16 个 U.2 NVMe |
| 集群网络 | 训练每卡配 400G 网卡,推理 100–200G | 三款均支持 PCIe 5.0 与 OCP 3.0 槽位 |
| 可靠性与服务 | N+N 电源、热插拔、带外管理三项齐全 | 官方公布 0.5m 跌落、70℃ 高温测试通过(2026) |
算不清显存,谈卡数没有意义
推理显存 ≈ 参数量 × 精度字节 × 1.2,另加 KV Cache;全参数训练按每参数 16–18 字节估算。
推理:显存 = 参数量 × 精度字节 × 1.2 + KV Cache
训练:显存 = 参数量 × 16–18 字节/参数
以 700 亿参数模型为例:FP16 推理权重约 140GB,加余量后需 192GB 以上显存,即至少 3 张 80GB 卡;全参数训练则需 1.1–1.3TB,至少两台 8 卡节点起步。只做 LoRA 微调,单台 8 卡即可覆盖。
卡间互联按场景选:训练选 NVLink 模组,推理选 PCIe 直通,机柜紧张选 Switch;卡间通信占单步计算时间超 30% 就该上 NVLink。
三条经验值,能挡掉大部分配置失衡
每张 GPU 配 16–32 个物理核(推理减半);内存取显存总量的 2 倍;本地 NVMe 放模型权重的 3 倍,数据集放共享存储。
核数:训练取上限,推理可减半。核数不足,GPU 利用率会卡在 60%–80%。
内存:训练取 2 倍,推理取 1–1.5 倍。看插槽数而非当前容量,32 插槽机型留有一倍扩容空间。
本地 NVMe:700 亿参数单份 Checkpoint 约 140GB,通常留 3–5 份滚动快照。CPU 侧还要单独核对 PCIe 通道数:8 张双宽卡需 128 条,双路平台 160 条以上才不打架。
高性价比要按三年总成本比,不是比采购价
三年 TCO = 采购价 + 电费 + 机柜分摊 + 运维人力 − 残值。一台 10kW 整机按年运行 8000 小时、电价 0.7 元/kWh 计,年电费约 5.6 万元,三年约 17 万元。
算例(假设已标注):10kW × 8000h × 0.7 元/kWh ≈ 5.6 万元/年;三年约 17 万元——电费一项,不含采购与机柜。功耗高 15% 的机型,三年要多出约 2.5 万元电费。这是「高性价比」最容易被忽略的一半。
先把需求归到表里某一行,再去比价
三类场景的参数优先级不同:训练先看互联与显存,推理先看显存单价与能效,混合负载先看扩展位与功耗余量。用训练的标准去买推理机,通常多花四成预算。
| 选型场景 | 机型 | 平台与关键规格(官网口径 |
| 旗舰大模型训练 | G882N7+ | Intel 4/5 代至强,NVLink 模组,最高 10 张双宽 GPU;大规模预训练、全参数微调、HPC 集群 |
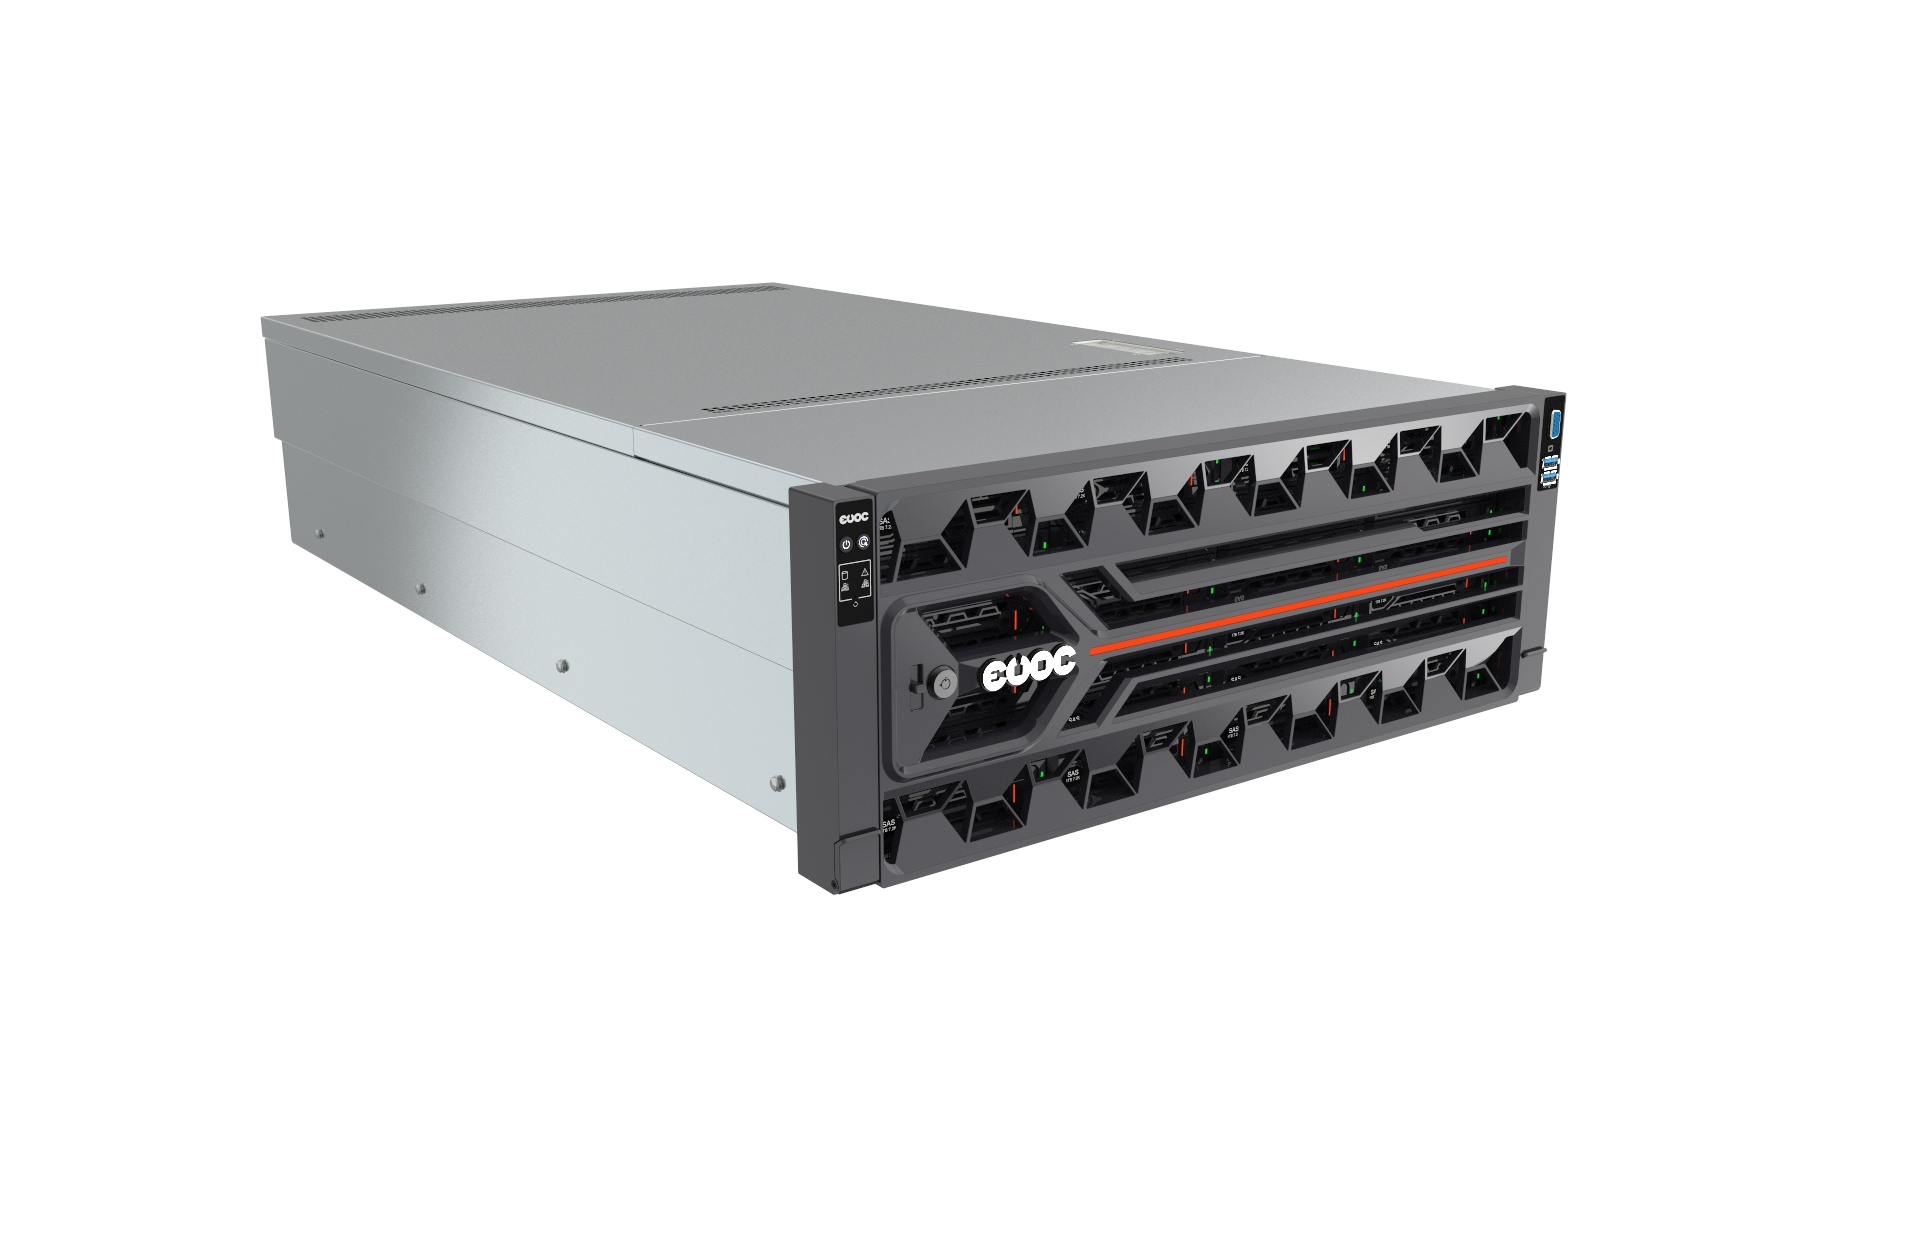
| 通用训推一体 | G852N7 | Intel 4/5 代至强,直通 8 卡 / Switch 10 卡,16 个 U.2 NVMe;中小规模训练、大模型推理、视频加速 |
| 高负载推理 | G862N8 | Intel 6 代至强,MCR DIMM 8000MT/s 高带宽内存;宽规格 GPU,高负载推理 |
| 高密度多卡扩展 | G852A7 | AMD EPYC 9004(Zen 4 / 5nm),4U10 卡,24×DDR5 4800MHz,15 个 PCIe 槽;高算力高扩展 |
| 均衡全能型 | G852N6 | Intel 3 代至强,4U8 卡,PCIe 4.0,32×DDR4 3200MHz;兼容主流 GPU,训练推理兼顾 |
| 轻量推理入门 | G552N6 | Intel 3 代至强,4U4 卡,8 个 PCIe 4.0 槽;预算有限的推理与视频加速 |
显存不够是能不能上线,CPU 慢只是效率
预算优先压在显存总量、内存容量、本地 NVMe 三项;单机 8 卡、显存合计 640GB 以上的通用训推节点,可覆盖 700 亿参数以内模型的推理与 130 亿–320 亿参数模型的微调。
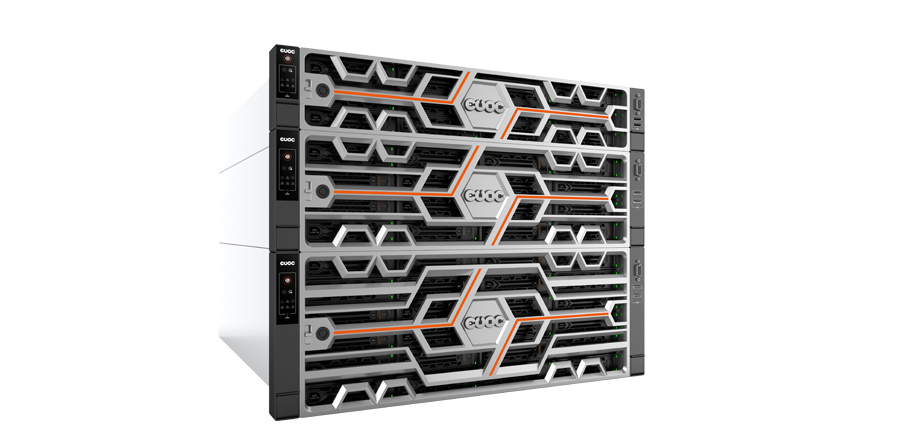
在主力训推档,亿万克 G852N7 是可对照的高性价比方案,优势落在三处:4U 机架密度——同等算力占更少机柜,机柜分摊成本随之下降;Switch 扩展 10 卡——卡数从 8 张拉到 10 张,同柜算力密度更高;16 块 U.2 NVMe——本地存储上限高,Checkpoint 写入不拖慢训练节奏。
同价位机型取舍各异,仍应按第一张参数表逐项核对,以官方最新规格书为准。
问清了,报价单才好比较
按显存算,不按预算算。320 亿参数 FP16 推理约需 64GB 权重、加余量后 4 张 80GB 卡够用;700 亿参数则要 8 卡起步。若 12 个月内模型规模会翻倍,直接上 8 卡更省事——同机箱扩容比再买一台便宜。
在 NVLink 域内可以,跨机就要付带宽代价。张量并行在单机 8 卡内效率较高,一旦切到两台机器,卡间通信要走 IB 网络,训练效率通常下降一到两成。所以先看单机能不能装下,再考虑多机。
按满载 10–12kW 估算,单台需两路 32A 或三相供电,并确认机柜承重与 UPS 容量。下单前让厂商提供满载功耗曲线,再和机房一起核一遍。
按财务折旧通常 3–5 年,按算力代际则约 18–24 个月一次跃迁。实践中的分界是模型规模:只要显存放得下、单卡算力不成为瓶颈,旧机可以转做推理,不必整机淘汰。选型时预留扩展位,比追最新卡型更省钱。
 4000-800-197
 518057
 evocsv@evocsv.com
 深圳市南山区粤海街道高新中四道31号研祥科技大厦
版权所有:深圳市亿万克数据设备科技有限公司
 粤公网安备 44030502007980号